

- BIOS/UEFI: дата, порядок загрузки, VT-x/AMD-V, режим RAID. Севшая CMOS-батарея могла сбросить всё.
- Диски: SMART по каждому накопителю, статус array, состояние батареи контроллера. ZFS-пул проверяй отдельно.
- Время: NTP, часовой пояс, tzdata. Kerberos и TLS отваливаются первыми при расхождении часов.
- Автозапуск: systemd-юниты, таймеры с Persistent, cron, состояние служб. Задачи без Persistent просто пропустятся.
- Файловая система: fsck, осиротевшие inode, точка монтирования, права. Без проверки ext4 легко теряет данные.
Диагноз: сервер стоял выключенным, а последствия накопились сами
Что проверить после простоя сервера, знает не каждый админ, потому что большинство инструкций написано для свежеустановленной системы. Реальность другая. Стойка стояла полгода без питания в холодном помещении. Или сервер лежал на складе после ремонта. Или коллега ушёл в отпуск и отключил весь кластер «чтоб не жужжал». Ты включаешь кнопку, кулеры крутятся, POST проходит, а дальше начинается.
Симптомы самые разные. Один сервер поднимается, но на диске не та ФС. Второй грузится, но сеть не поднимается, потому что MAC зачем-то сменился. Третий запускается, но время отстало на четыре месяца, и половина служб не может пройти аутентификацию. Четвёртый молчит: щёлкает релюшка, шпиндель дёргается и встаёт.
По факту простоем называется любое отключение дольше пары недель. За это время успевают деградировать батарейки, окислиться контакты, усохнуть смазка в подшипниках HDD, разрядиться BBU у RAID-контроллера. Софт тоже не стоит на месте: сертификаты истекают, ключи Kerberos протухают, таймеры systemd пропускают запуски, ZFS накапливает неисправные блоки.
Дальше разберём их по порядку. Сначала подготовка, потом чек-лист по слоям: железо, контроллеры, диски, ОС, время, сеть. Каждый шаг с командой, ожидаемым результатом и точкой отката. Ориентировочно на всё уходит 40-90 минут на один сервер, если он живой, и от нескольких часов, если что-то сломалось.
Что нужно под рукой:
- Физический доступ к серверу или IPMI/iDRAC/iLO. Без KVM-консоли вслепую ты ничего не сделаешь.
- Загрузочный USB с дистрибутивом и live-режимом. Ubuntu Server 24.04 LTS подходит, актуальная на момент написания версия, проверяй релизы перед записью.
- Свежий бэкап конфигов и данных. Если его нет, сначала снимай дамп с дисков, пока они живы, и только потом пытайся грузить систему.
- Заведомо исправный NTP-сервер, доступный по сети. Внутренний или публичный пул.
- Доступ к вендорским утилитам:
smartctl,storcliилиperccli,ipmitool,mstflintдля NIC.
Чего делать нельзя: сразу подключать к продакшн-сети и запускать нагрузку. Даже если система поднялась. Один прогон fsck на подозрительном массиве дешевле ночного восстановления из бэкапа.
Почему после простоя железо и софт ведут себя не так
Причины, из-за которых сервер после простоя ломается предсказуемо и в одном и том же месте.
| Причина | Что именно ломается | Как проявляется |
|---|---|---|
| Разряд CMOS-батареи | Настройки BIOS/UEFI, дата, порядок загрузки, VT-x/AMD-V, режим RAID | Сервер не находит загрузчик или не стартует виртуалка |
| Деградация BBU RAID-контроллера | Write cache теряет защиту от отключения питания | Первый же сбой питания рвёт ФС |
| Залипание шпинделя HDD | Механика HDD, подшипники, смазка | Щелчки, диск не раскручивается, массив в degraded |
| Накопленные ошибки контрольных сумм | ZFS-пулы, scrub, производительность | Долгий scrub при старте, просадка IOPS |
| Расхождение системных часов | Kerberos, TLS, журналы, cron | Аутентификация падает, логи перемешаны по времени |
| Пропущенные таймеры и cron | systemd-timers, cron, Scheduled Jobs | Бэкапы не запустились, ротация не прошла |
| Отсутствие кворума в кластере | Proxmox VE, corosync, etcd | Кластер переходит в read-only |
| Сброс NVRAM коммутатора | Конфигурация свитча/роутера | Устройство поднимается с настройками «из коробки» |
Восемь строк в таблице, а на одном конкретном сервере ломается обычно два-три пункта. Угадать заранее невозможно, поэтому проверяют всё по порядку.
Рецепт: как проверить сервер после долгого простоя
Подготовка к работе
Перед первым включением отключи сервер от продакшн-сети. Воткни в отдельный VLAN или напрямую в ноутбук. Причина простая: если ОС стартует с прошлогодними настройками, службы начнут дёргать внешние сервисы, писать в бэкапы, рассылать алерты, заявляться в кластер. Один такой сервер, включённый «на минутку проверить», способен уронить общий NFS-шар.
Подготовь инструменты на USB: свежий образ Ubuntu Server 24.04 LTS, актуальная на момент написания версия, проверяй релизы перед записью. Запиши через dd или Rufus. Загружайся с него, если основная ФС не поднимается или ведёт себя странно.
И самое главное: до любого включения прикинь план отката. Если данные на дисках ценные, первым делом снимай посекторный образ на отдельное хранилище, пока шпиндели живы. ddrescue с журналом спас не один массив после залипшего HDD.
Системные требования и версии инструментов
| Компонент | Версия | Примечание |
|---|---|---|
| ОС сервера | Ubuntu Server 22.04 / 24.04 LTS | Актуальная на момент написания. Проверь релизы перед установкой. |
| Загрузочный live-USB | Ubuntu 24.04 LTS Desktop или Server | Тот же релизный цикл, лучше совпадение ядра и утилит |
| smartmontools | 7.4+ | Для диагностики HDD/SSD, работает на любом дистрибутиве |
| OpenZFS | 2.2+ | Совпадает с версией ядра Proxmox VE 8 и Ubuntu 24.04 |
| chrony | 4.5+ | Штатный NTP-клиент в Ubuntu, есть поддержка makestep |
| storcli / perccli | Последняя с сайта вендора | Для Broadcom/LSI контроллеров, версия зависит от модели |
| ipmitool | 1.8.19+ | Для доступа к BMC, версия команд отличается от вендора к вендору |
На момент публикации актуальны указанные версии. Перед установкой проверь свежие релизы на официальных сайтах проектов: smartmontools, OpenZFS, chrony.
Порты и доступы, которые стоит держать открытыми
| Порт | Протокол | Назначение | Снаружи |
|---|---|---|---|
| 22 | TCP | SSH | Только с IP админ-хоста |
| 123 | UDP | NTP | Только к внутренним NTP-серверам |
| 8006 | TCP | Proxmox VE web UI | Закрыт, доступ через VPN или jump-хост |
| 3128 | TCP | SPICE proxy в Proxmox | Закрыт |
| 8000-8010 | TCP | IPMI/BMC web | Только из админ-подсети |
| 5900-5999 | TCP | VNC/SPICE консоль | Закрыт, только локально |
На этапе диагностики всё, кроме 22 и 123, должно быть закрыто на внешнем периметре. Открой вендорский BMC-порт только для IP админ-машины.
Схема проверки по слоям
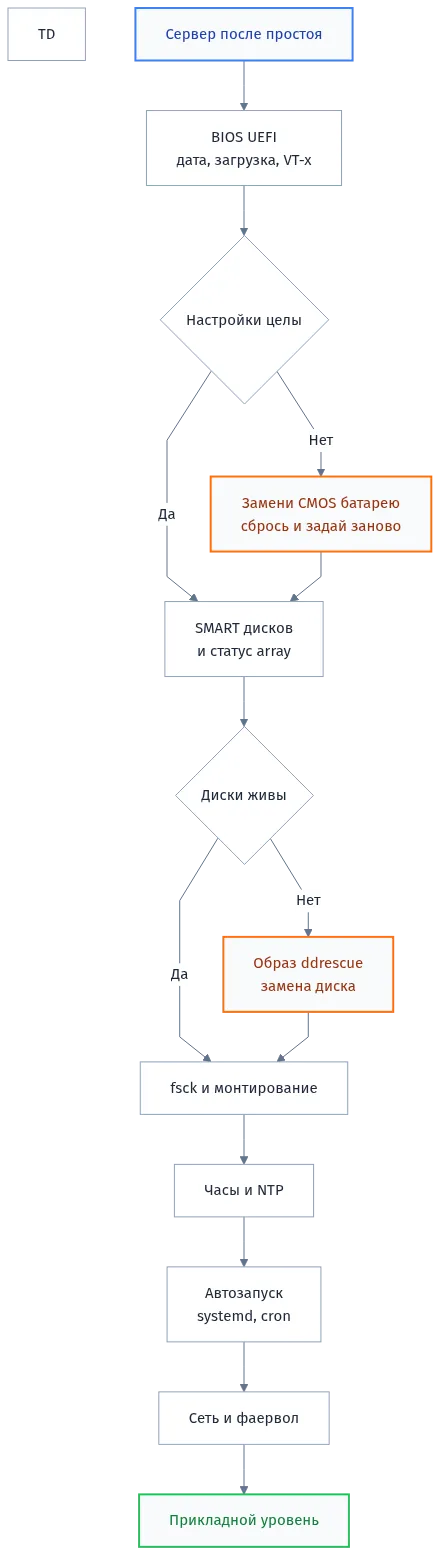
Шаг 1: включение и проверка BIOS/UEFI
Включай питание, но не спеши грузиться. Зайди в BIOS/UEFI через IPMI или локальную клавиатуру. Проверь три вещи: текущую дату, порядок загрузочных устройств, состояние виртуализации. Если дата отстала или ушла в 2010 год, CMOS-батарея разряжена или села до критического уровня. Тогда SRAM могла остаться без питания, и все настройки сбросились.
Порядок загрузки почти всегда сбрасывается на дефолт, обычно в LAN или PXE. Сервер начинает ждать сетевой загрузки и через 30 секунд уходит в fallback на следующий диск. Если ты не смотришь в консоль, это выглядит как «сервер не грузится».
Смотри на пункт виртуализации. VT-x на Intel или AMD-V на AMD. Если он выключен, hypervisor не стартует, KVM не поднимется, Proxmox VE будет валиться с ошибкой типа KVM: disabled by bios. То же самое с режимом контроллера: был AHCI, стал RAID, и Linux перестаёт видеть boot-раздел.
Замени батарейку CR2032, если дата сбрасывается повторно. Стоит копейки, меняется за минуту. Артикул ищи по плате или по документации вендора. Проверь после замены: выключи сервер, подожди час, включи, дата должна остаться.
Шаг 2: диагностика дисков через SMART
Диски после простоя это самое слабое звено. Смазка в подшипниках загустевает, шпиндель залипает, поверхности могут получить микроцарапины от парковочной зоны. Проверять нужно каждый диск отдельно, а не только статус массива. RAID-контроллер поднимает массив из живых дисков, но не скажет, что один из них умирает прямо сейчас.
smartctl -x даёт полный дамп атрибутов. Смотри на Reallocated_Sector_Ct, Current_Pending_Sector, Offline_Uncorrectable, Spin_Retry_Count, Load_Cycle_Count. Любой ненулевой Pending_Sector после простоя плохой признак.
for d in /dev/sd?; do
  echo "=== $d ==="
  smartctl -H -A "$d" | grep -E 'SMART overall|Reallocated|Pending|Offline_Uncorrect|Spin_Retry'
done
Ожидаемый результат: по каждому диску строка SMART overall-health self-assessment test result: PASSED, атрибуты Reallocated и Pending в нуле. Всё, что отличается, откладывай в сторону и планируй замену.
Для SSD смотри отдельные атрибуты: Wear_Leveling_Count, Media_Wearout_Indicator, Percent_Lifetime_Remain. SSD после простоя в холодной комнате теряет заряд в NAND-ячейках, иногда до полной потери данных. Такой диск честнее заменить сразу.
Шаг 3: массив и батарея контроллера
RAID-контроллер проверяй вендорской утилитой. По факту одна команда даёт всю картину: состояние виртуальных дисков, физических носителей, кеша и батареи.
sudo storcli /c0 show all | less
sudo storcli /c0/bbu show all
Смотри на строку State: Optimal для VD и PD. Если VD в Degraded или Partially Degraded, не жми Rebuild сразу, сначала проверь, какой диск выпал и почему. Диск мог выпасть из-за плохого контакта в бэкплейне, а не потому что умер.
Строка BBU (Battery Backup Unit) критична. Если статус Failed или Charging, включён режим WriteThrough вместо WriteBack. Это значит, что первый же сбой питания при активной работе порвёт файловую систему. Не запускай нагрузку, пока BBU не восстановилась или пока контроллер честно не переключился в безопасный режим.
Данному классу проблем посвящён отдельный разбор у вендоров. Смотри документацию Broadcom про RAID controllers и Battery Backup, ссылку на главную страницу даю без глубоких ссылок: broadcom.com/products/storage/raid-controllers.
Шаг 4: файловая система и fsck
Если сервер выключался некорректно, ext4 оставляет в журнале незакрытые транзакции. Автопроверка при загрузке срабатывает не всегда, особенно если диск был смонтирован в /etc/fstab с параметром 0 в последнем поле. Тогда ядро просто монтирует ФС в ro после ошибок, а пользователь видит частично доступную систему.
Грузи live-USB, отмонтируй раздел, прогони fsck в интерактивном режиме. Все ответы y, но читай, что именно чинится. Осиротевшие inode можно связать или удалить, а вот потерянные блоки в data-разделах это потенциальная дыра в файлах.
sudo umount /dev/sda2
sudo fsck.ext4 -f -y /dev/sda2
sudo e2fsck -f -y -C 0 /dev/sda2
Ожидаемый результат: файловая система clean, количество ошибок в логе нулевое. Если fsck показывает recovering journal и уходит с кодом 0, повезло. Если сыпет Multiply-claimed blocks, Inode bitmap differences, дальше действуй осторожно: сначала снимай посекторный образ, потом ремонтируй.
Для ZFS проверь пул отдельно, не через zpool status как обычно, а с детализацией. Прогоняй scrub явно, даже если система не жалуется.
sudo zpool import -o readonly=on
sudo zpool status -v
sudo zpool scrub tank
sudo zpool status tank
Ожидаемый результат: state: ONLINE, scan: scrub in progress или scan: scrub repaired 0B. Всё, что с DEGRADED или FAULTED, разбирай до включения нагрузки. При наличии ошибок контрольных сумм scrub на ZFS может идти часами, это нормально.
Шаг 5: время, NTP и часовой пояс
Расхождение часов после простоя почти гарантированно. Отставание может быть на дни, недели, месяцы. Большие скачки NTP не выправит быстро: chronyd по умолчанию тормозит слишком сильные корректировки, чтобы не ломать приложения.
Проверь текущий статус, потом задай часовой пояс и стартуй синхронизацию принудительно. Штатный NTP-клиент в Ubuntu это chrony, конфиг в /etc/chrony/chrony.conf.
timedatectl status
sudo timedatectl set-timezone Europe/Moscow
sudo systemctl enable --now chronyd
sudo chronyc sources -v
sudo chronyc makestep
Ожидаемый результат: в timedatectl строка System clock synchronized: yes, часовой пояс совпадает с рабочим. В chronyc sources все источники со звёздочкой, значения offset small.
Настройка на принудительный шаг при первом старте полезна после долгого простоя. Одна строка makestep 1.0 3 в конфиге разрешит первые три обновления сдвигать время резко, дальше плавно.
Шаг 6: автозапуск служб, таймеры и cron
systemd и cron после простоя ведут себя по-разному, в зависимости от того, как ты их настроил. Задания с Persistent=true отработают один раз при первом запуске, даже если время давно прошло. Задания без Persistent просто пропустятся, никаких уведомлений.
Смотри, что запустилось и что пропустилось, до того, как включить сеть.
systemctl list-units --type=service --state=failed
systemctl list-timers --all
sudo systemctl status my-backup.timer
sudo journalctl -b -u my-backup.service --since "1 day ago"
Ожидаемый результат: ни один критичный сервис не в failed. Таймеры перечислены с датой следующего запуска. Резервные копии и ротация показываются в LAST как прошедшие или как запланированные.
Для системного cron проверь /var/spool/cron/crontabs/ и /etc/cron.d/. Anacron в Ubuntu настроен на догон пропущенных задач, но только для скриптов под /etc/cron.daily, /etc/cron.weekly и так далее. Пользовательские cron-задачи в crontab -e никто не догоняет.
Шаг 7: сеть, MAC и фаервол
Сменившийся MAC-адрес это классика после замены материнки или сброса NVRAM сетевой карты. DHCP выдаёт новый IP, ARP-таблицы на свитчах оседают старыми записями, кто-то в мониторинге кричит «хост пропал». Проверь интерфейсы и сравни с инвентарём.
ip -br link show
ip -br addr show
sudo ethtool -i eth0
cat /etc/netplan/*.yaml
sudo netplan --debug apply
Ожидаемый результат: интерфейсы UP, IP и MAC совпадают с инвентарём. Файл Netplan валидный, применение проходит без ошибок. Если MAC временный, проверь macchanger и udev rules в /etc/udev/rules.d/.
Фаервол проверь сразу после сети. Правила после простоя могли примениться в другом порядке, особенно если они приходят из системы управления конфигурациями.
sudo ufw status verbose
sudo iptables -S
sudo nft list ruleset
Ожидаемый результат: ufw активен, разрешены только нужные порты, SSH доступен с админ-подсети. Наружу ничего лишнего не торчит. Если правил нет вообще, не торопись открывать SSH широко: сначала открой доступ только с конкретного IP, потом продолжай.
Безопасность на этапе настройки
Несколько правил, которые важнее самих команд. Первое: пока сервер не проверил часы, не подключай его к Kerberos-домену. Аутентификация упадёт, ключи запишутся с неверными временными метками, разгребать неделю.
Второе: пароли и ключи, которые сервер хранил в открытом виде, считай скомпрометированными после замены железа. Диск мог быть клонирован до тебя, а мог не быть. Ротация ключей дешевле, чем разбор инцидента. То же со SSH host key: если его кто-то подменил, клиенты ругнутся на REMOTE HOST IDENTIFICATION HAS CHANGED.
Третье: BMC и IPMI не выставляй наружу. Даже временно. Прошивки IPMI славятся бэкдорами, а обновить их сложнее, чем поставить apt upgrade.
Четвёртое: если сервер вернулся в продакшн, сразу поставь его под fail2ban для SSH. Он может быть в старой конфигурации, где пароли разрешены, а ключи никому ненужны.
sudo apt install fail2ban
sudo systemctl enable --now fail2ban
sudo fail2ban-client status sshd
Ожидаемый результат: Jail 'sshd' активен, брутфорс блокируется. Дефолтные правила отсекают пять неудачных попыток за десять минут на час.
Проверка после запуска
Сервер поднялся, службы в active, диски ONLINE. Это не значит, что всё чисто. Прогони чек-лист ниже и только после него снимай сервер с изоляции.
uptime
uptime -s
date
timedatectl
systemctl --failed
dmesg --level=err,warn | tail -n 50
journalctl -p err -b --no-pager | tail -n 80
df -hT
free -h
ip -br a
ss -tulpn
smartctl -H /dev/sda /dev/sdb /dev/sdc
zpool status -x
sudo mdadm --detail /dev/md0
Что искать в выводе. Читай каждую строку и сверяй с нормой:
| Проверка | Норма | Что делать при отклонении |
|---|---|---|
uptime -s |
Совпадает с моментом включения | Часы неверны, правь NTP |
systemctl --failed |
0 units listed | Разбирай по одному, начиная с тех, что нужны для загрузки |
dmesg --level=err,warn |
Без ошибок устройств | Ошибки I/O, таймауты дисков, сбои NIC |
df -hT |
Все ФС смонтированы, infose | ФС в ro после ошибок, монтируй в live, чини fsck |
ss -tulpn |
Только ожидаемые порты | Лишние слушатели, откопай юниты и отключи |
smartctl -H |
PASSED на всех | FAILED, меняй диск |
ZFS zpool status -x |
all pools are healthy | Если что-то не так, разбирай до запуска нагрузки |
mdadm --detail |
state: clean |
Rebuild или recovery, смотри причину выпадения |
Отдельно проверь журналы прикладного ПО. Не только за текущий запуск, а с прошлого успешного дня. Если сервер писал в файл, а файл открывается сейчас пустым, возможно журнал пересоздался или ФС рвануло на уровне inode. Сравни размеры файлов с последним бэкапом.
Последнее и самое частое. Не запускай сразу тяжёлую нагрузку. Дай системе сутки поработать в минимальном режиме: проверить бесперебойность, прогнать scrub, дать BBU зарядиться. Вот тут одна строка в crontab без комментария способна убить весь отдел, так что не забудь выключить автоскрипты, которые кто-то настроил до тебя.
Если после всех шагов сервер работает, а любая попытка запустить нагрузку валит его через 10 минут, это не обязательно железо. Смотри thermal_zone, температуры CPU и дисков, состояние вентиляторов. После простоя термопаста под радиаторами сохнет, а кулеры могут не раскрутиться до нужной скорости. Проверь ещё раз ipmitool sdr и sensors, прежде чем копать дальше.
Осложнения, типичные ошибки, разбор альтернативных стратегий запуска, профилактику, чтобы следующий простой прошёл дешевле, и ответы на самые частые вопросы уже разбираю ниже.
Осложнения после простоя: разбор частых ошибок
Ты включил, вроде всё поехало. Через час начинается непонятное. Ниже те самые грабли, на которые наступают все, кто поднимает железо после долгого простоя, плюс команды лечения.
Кворум Proxmox не собрался, кластер ушёл в read-only
Запустил три узла Proxmox не одновременно, последний поднялся через сорок минут. Кластер собрал кворум из двух из трёх, а третий висит в состоянии ожидания. Через какое-то время виртуалки перестают писать на диск, миграции не идут, веб-морда показывает вопросики.
Причина в том, что при потере кворума corosync переводит менеджер ресурсов в режим без записи. Узлы выключенные одновременно и стартующие вразнобой гарантированно дают такую картину.
Решение: проверить состояние кворума, подождать, пока все узлы поднимутся, и руками вернуть кворум определённому узлу, если часть серверов не стартует.
pvecm status
pvecm nodes
corosync-quorumtool -s
journalctl -u pve-cluster -n 100 --no-pager
Ожидаемый вывод: Quorate: Yes и Votequorum Expected votes больше нуля. Если Quorate: No, поднимай недостающие узлы. Кворум в два узла из трёх восстанавливается сам, когда третий снова виден в сети.
Залипший шпиндель HDD: щёлкает и не раскручивается
Диск лежал в стойке восемь месяцев, смазка подшипников подсохла. При включении слышно ритмичное «клац-клац», SMART пустой, диск не определяется в BIOS.
Причина: залипание шпинделя и потеря свойств смазки. Чем дольше простой, тем выше риск, особенно у дисков старше пяти лет.
Решение: не включать на холодную повторно двадцать раз. Снять диск, дать полежать при комнатной температуре, попробовать раскрутить в отдельном внешнем боксе без доступа к рабочей системе. Если после трёх попыток диск не выходит в готовность, копирование данных через специалистов, платы не менять в надежде на чудо.
smartctl -a /dev/sdb
smartctl -t short /dev/sdb
dmesg | tail -50
Хороший признак, если в выводе smartctl появились атрибуты и Power_On_Hours. Если команда возвращает «Device not ready», диск не отдаёт идентификацию, дальше стучать в него бессмысленно.
Осиротевшие inode на ext4 после отключения питания
Питание ушло без корректного завершения, файловая система осталась с рассинхронизированными метаданными. Неприятность в том, что при загрузке fsck может отработать в фоне и часть данных исчезнет тихо.
Причина: незавершённые журнальные транзакции. При длительном простое после такого выключения часть inode помечается как orphaned, а некоторые файлы теряют связь с каталогом.
Решение: перевести корень в режим только чтения и прогнать fsck руками, а не авто, чтобы видеть отчёт.
mount -o remount,ro /
fsck.ext4 -fvy /dev/mapper/vg0-root
Флаг -y подтверждает исправления автоматически, -f заставляет проверку, даже если файловая система помечена чистой. После завершения проверь dmesg на строки EXT4-fs error и lost+found.
dmesg | grep -i "EXT4-fs"
ls -la /lost+found
Если в lost+found появились файлы, открой каждый, сверь с бэкапом. Часть может быть восстановлена по имени inode.
CMOS-батарея села: сброс BIOS, VT-x отключён, RAID забыл конфигурацию
После года простоя сервер стартует, но загрузка идёт не с того диска, виртуалки не запускаются, а RAID-контроллер показывает массив в состоянии Foreign Config.
Причина: батарейка CR2032 разрядилась, настройки BIOS/UEFI сбросились к заводским. VT-x, IOMMU, порядок загрузки, конфигурация RAID на дискретном контроллере, всё слетело.
Решение до первого включения: заменить батарейку, потом уже идти в BIOS и восстанавливать настройки. Если контроллер RAID спрашивает про Foreign Config, отвечай Import, не Initialize, иначе данные пропадут.
dmidecode -t bios
ipmitool sel list
dmidecode покажет версию BIOS и дату релиза. Если дата сбросилась на 2000 год, батарейка точно сдохла. ipmitool выдаст журнал событий BMC, там будет отметка о потере часов реального времени.
Батарея RAID-контроллера деградировала: write cache отключён
RAID с battery-backed write cache после простоя работает медленнее в разы. Запись 500 МБ/с превращается в 40 МБ/с, всё встаёт колом, приложения таймаутят.
Причина: за время простоя батарея разрядилась, контроллер выключил write cache для защиты данных. С включённым кэшем при сбое питания без батареи контроллер мог бы потерять часть записей.
Решение: посмотреть статус батареи, дождаться перезарядки, включить кэш обратно в режиме WriteBack после полного заряда.
storcli /c0/bbu show all
storcli /c0/v0 show all
storcli /c0/v0 set wrcache=WB
Ожидаемый статус батареи Healthy. Если состояние Failed или Optimal, но Learn cycle не завершён, кэш включать рано. Дождись окончания цикла обучения, он занимает 12-24 часа.
Замок лицензии не пускает после замены железа
Поменял материнскую плату или процессор при восстановлении, и софт, привязанный к серийному номеру, требует повторной активации. Managed-коммутаторы, MSS-контроллеры, некоторые СУБД и системы виртуализации грешат этим.
Причина: лицензия шита по MAC, серийнику CPU или идентификатору материнки. После смены компонента проверка не проходит.
Решение: у каждого вендора своя утилита повторной активации. Общий шаг такой: посмотреть, к какому идентификатору была привязана лицензия, попробовать вернуть старый идентификатор через software или железный джампер, если не выходит, открывать тикет в поддержку.
# Общий шаблон для софта, привязанного к MAC или CPU
ip link show
dmidecode -t processor | grep -i "ID"
lscpu
Собери вывод до обращения в поддержку. Половина времени ответа вендора уходит на переспрос этих данных.
Синхронизация времени после большого расхождения часов
Часы ушли на полгода вперёд или назад. chrony или ntpd при старте не прыгает на минуты, а аккуратно сдвигает часы миллисекундами. При расхождении в часы синхронизация может идти десятками минут, а до тех пор kerberos, TLS и логи работают неправильно.
Причина: политики time sync защищают от резких прыжков, потому что прыжок ломает монотонность. При долгом простое это влияет как раз хуже всего.
Решение: разрешить один резкий шаг руками через chronyc makestep или ntpd -gq, потом уже полагаться на штатную синхронизацию.
chronyc makestep
chronyc tracking
timedatectl status
Проверяй NTP-серверы доступны, система на UTC, RTC не в локальном времени. В systemd-timesyncd команда одна:
timedatectl set-ntp true
timedatectl status
cron-задачи молча пропустили запуск
Через сутки после включения сервера никто не получил еженедельный отчёт. Задача не запустилась ни разу.
Причина: в cron задачи без параметра Persistent пропускаются, если система была выключена в нужный момент. В systemd-timers с Persistent=true задача догоняется один раз после загрузки, с Persistent=false игнорируется.
Решение: перевести критичные задачи на systemd-timers с Persistent=true. Тогда после простоя один раз запустится то, что было пропущено.
[Unit]
Description=Weekly report

[Timer]
OnCalendar=Mon 06:00
Persistent=true

[Install]
WantedBy=timers.target
Проверка статуса таймеров и списка следующих срабатываний:
systemctl list-timers --all
systemctl status myreport.timer
journalctl -u myreport.service --since "2 days ago"
ZFS-пул проходит scrub и тормозит всё
После простоя Proxmox VE 8 запускает scrub на ZFS. Диски заняты, IOPS проседают, виртуалки подлагивают. На больших пулах это может занять сутки и больше.
Причина: накопились ошибки контрольных сумм, ZFS проверяет каждую метаданные и лечит по мере возможности.
Решение: не выключай scrub, дай ему дойти до конца, но снизь нагрузку через параметр zfs_scan_vdev_limit. Если данных мало и пул маленький, просто подожди.
zpool status
zpool scrub -p tank
zfs get all tank | grep scan
Ключ -p ставит scrub на паузу. Продолжить: zpool scrub tank отменит паузу.
Альтернативы: как поднимать железо после простоя, если есть выбор
Классическая схема: включил всё сразу и смотришь, что отвалится. Работает, когда простоял сервер два дня, а не полгода.
Второй вариант: консервация перед выключением. Снять батареи, упаковать диски отдельно, вынуть шпиндельные блоки, забрать конфиги в Git. На восстановление уходит меньше времени, потому что ты знаешь, что где лежит.
Третий: стенд-проверка. Сначала поднимаешь на изолированной сети, прогоняешь SMART, memtest, fsck. В прод выводишь только после проверки. Так работают в компаниях, где потеря данных стоит дороже двух дней простоя стенда.
Четвёртый: замена парка на VPS или облако на время проверки. Хорошо, когда железо старое и неясно, выживет ли оно вообще. Минус в том, что перенос данных между площадками занимает больше времени, чем сама диагностика.
| Подход | Когда применять | Риск потери данных | Время на подъём |
|---|---|---|---|
| Прямое включение | Простой до 2 недель | Средний | 1-2 часа |
| Консервация заранее | Плановое отключение на месяцы | Низкий | 2-4 часа |
| Стенд-проверка | Критичные данные | Очень низкий | 1-2 суток |
| Замена на VPS | Железо на грани отказа | Средний при переносе | от 3 суток |
Я в большинстве случаев делаю стенд-проверку, если есть физический доступ и запас железа. Два дня работы станции дешевле, чем восстановление из бэкапа, которому полтора года.
Профилактика: чтобы следующий раз прошёл легче
Мониторинг состояния железа
SMART-мониторинг на каждом диске. Если у диска за сутки появляются новые Reallocated Sector Count или Current_Pending_Sector, замена на очереди, а не «понаблюдаем».
smartctl -a /dev/sda | grep -E "Reallocated|Pending|Power_On_Hours"
smartctl -a /dev/sda | grep -i "UDMA_CRC"
UDMA CRC Error растёт после простоя быстрее всего из-за плохого питания и старения кабелей. Замена кабеля SATA стоит копейки, потеря данных стоит дороже.
Собирать метрики удобно через node_exporter, проверки добавлять в Zabbix или Prometheus. В Zabbix есть готовые шаблоны для SMART через smartctl, в Prometheus работает официальный smartctl_exporter.
Что мониторить обязательно:
- SMART всех дисков и состояние RAID
- Перезарядка и состояние батареи контроллера
- Состояние кворума Proxmox
- Расхождение времени NTP в миллисекундах
- Запуск критичных timer- и cron-задач
- Свободное место и рост базы, если имеет значение
Бэкап: что копировать и куда
Бэкап это то, что уцелеет после сдохшего железа. Если бэкап лежит на том же RAID-массиве, что данные, после простоя можно потерять оба.
Минимальный бэкап для сервера:
- Конфиги: /etc целиком, Inventory Ansible, конфиги БД, файлы лицензий, схемы сети
- Данные приложений: только те, что нельзя пересоздать из кода или миграций
- Логи: за последние 90 дней, если есть требования аудита
- Пароли и ключи: в отдельном зашифрованном хранилище, не рядом с основным бэкапом
Частота зависит от цены данных. Стандарт, который я использую: конфиги ежедневно, БД каждые 4 часа со сроком хранения 30 дней, полный образ раз в месяц. Все три копии в трёх местах: продакшн, отдельная стойка, внешнее хранилище. Правило 3-2-1 никто не отменял.
# Быстрая проверка, что бэкап вообще создаётся и растёт
ls -lah /backup/postgres/
journalctl -u pgbackrest --since "1 week ago" | grep -i error
du -sh /backup/postgres/
Восстановление проверяется не на бумаге, а руками: раз в квартал разворачиваешь бэкап на отдельной машине и запускаешь приложение. Если не получилось, у тебя нет бэкапа, есть только файлы.
Автозапуск сервисов после включения
Половина «сервер после простоя не работает» это не про железо, а про сервис, который никто не включил. Проверь enabled-состояние после первого запуска.
systemctl list-unit-files --state=enabled | wc -l
systemctl list-units --failed
Первая команда покажет число автозапускаемых юнитов. Вторая выведет всё, что упало в failed. Раз в сутки после восстановления смотри list-units —failed и разбирай.
Безопасность после простоя
Сервер полгода стоял выключен, а список уязвимостей на нём не полежал вместе с ним. После включения SSH открой только с доверенных IP, включи fail2ban, обнови пакеты безопасности до подключения к внешней сети.
ufw default deny incoming
ufw allow from 10.0.0.0/24 to any port 22 proto tcp
ufw enable
apt update && apt upgrade -y
apt install fail2ban -y
systemctl enable --now fail2ban
SSH hardening: PasswordAuthentication no, PermitRootLogin no, AllowUsers с явным списком. Ключи проверить заранее, иначе закроешь себе вход.
# /etc/ssh/sshd_config.d/10-hardening.conf
PermitRootLogin no
PasswordAuthentication no
PubkeyAuthentication yes
AllowUsers andrey deploy
MaxAuthTries 3
Перед reload проверь синтаксис:
sshd -t
systemctl reload ssh
Безопасное обновление и откат
После долгого простоя пакетов накопится много. Обновлять всё сразу и сразу в прод не стоит, но растягивать на месяц тоже не выход.
Порядок такой: сначала бэкап, потом snapshot или LVM, потом ядро, потом остальные пакеты, перезагрузка на новое ядро, сутки работы под наблюдением, потом ядро старое удалять, если нет вопросов.
apt update
apt list --upgradable | wc -l
uname -r
apt install linux-image-generic -y
apt upgrade -y
reboot
Откат: если после перезагрузки ломается сеть или диск, в GRUB выбираешь старое ядро. Если ломается сервис, откатываешь пакет до конкретной версии.
apt install package=1.2.3-1
apt-mark hold package
Держись правила: обновляй часто и по чуть-чуть. Раз в месяц по три обновления проходит спокойнее, чем раз в год двести пакетов разом.
FAQ: что чаще всего спрашивают после простоя
Почему сервер не работает после настройки и включения?
Чаще всего проблема не в настройке, а в железе. CMOS-батарея села, BIOS сбросил порядок загрузки, VT-x выключился. Проверь dmidecode, потом заходи в BIOS и восстанавливай параметры. Второй по частоте случай это разряженная батарея RAID-контроллера, из-за которой write cache отключён и всё встало колом.
Как проверить, что диск после долгого простоя рабочий?
Сначала SMART: smartctl -a показывает атрибуты и Power_On_Hours. Если диск отвечает, гоняй короткий тест smartctl -t short, потом длинный smartctl -t long. Проверь поверхность утилитой badblocks в режиме неразрушающей проверки. Если дmesg сыплет I/O error и UDMA CRC растёт, диск или кабель под замену, данные копировать немедленно.
Что делать, если RAID-контроллер потерял конфигурацию?
Никогда не нажимай Initialize. Выбирай Import Foreign Config на импортируемом массиве. Если контроллер не может восстановить конфигурацию, есть шанс собрать массив вручную по дискам, но только если знаешь порядок и размер полосы. Либо в сервис, где это сделают за деньги. Данные на дисках ещё лежат, если их не перезаписали.
Чем Proxmox отличается от обычного KVM по работе с кластером после простоя?
KVM это гипервизор, а Proxmox это менеджер с кластером поверх. У Proxmox есть corosync, есть режим read-only при потере кворума, есть синхронизация конфигов между узлами. В чистом KVM этих слоёв нет, каждый хост сам за себя. После простоя кластера Proxmox сначала поднимают кворум и только потом ВМ.
Что делать, если cron задачи не выполнились после выключения?
Проверь, есть ли параметр Persistent=true у systemd-timer или используй anacron для cron. При единичном запуске после простоя оба варианта догонят пропущенные задачи. Смотри журнал: systemctl list-timers —all и journalctl -u timer_name. Если задача была в cron без persistent, она просто не запускалась, потому что момент был пропущен.
Как понять, что NTP реально синхронизировался?
chronyc tracking покажет текущее смещение и статус. В поле System time должна быть близкая к нулю цифра, а Leap status: Normal. Пока не увидел эти два показателя, kerberos и TLS будут вести себя странно. Если расхождение огромное, разреши единичный шаг chronyc makestep, потом ждать полной синхронизации не нужно.
Что первым делать, если сервер включается, но не подаёт признаков жизни?
Первым делом проверь индикаторы на материнской плате, потом BMC через ipmitool. У большинства серверов есть IPMI или iDRAC, где видно, что именно не поднялось. Если BMC молчит, смотри питание и батарею CMOS. Мемтест и проверка оперативной памяти дёшевы и снимают много вопросов, когда неясно, почему нет POST.
Что в итоге
Мы прошли по всей цепочке: от кворума Proxmox до батареи CMOS, от залипшего шпинделя до угнавшихся inode на ext4. Каждое осложнение имеет конкретную команду проверки и точку отката. Главное правило одно: не выводи сервер в бой, пока не убедился, что диски, время, автозапуск и бэкапы на месте.
Профилактика здесь не теория, а конкретный набор действий: мониторинг SMART, бэкапы по 3-2-1, quarterly-проверка восстановления, обновления по чуть-чуть. Это то, что отделяет спокойные ночи от пожаров. Если через полгода после восстановления у тебя не возникнет вопросов, было ли что-то забыто, значит проверка была правильной.

Author: Александра Сергеевна
Оставайтесь на связи
Рецепты от IT-боли. Без воды, без рекламы, без маркетинговой шелухи.
Подписаться на IT-Аптеку →


Застрял на моменте с RAID-контроллером: если BBU в статусе Failed или Charging, ты советуешь не грузить систему до полной зарядки, но как понять, что контроллер реально заряжает батарею, а не просто показывает статус? В моём случае после 4 месяцев простоя storcli показывает BBU: Charging уже 12 часов, а ёмкость не растёт. Это нормально или батарею сразу под замену? И можно ли временно переключиться в WriteThrough, чтобы поднять массив, или это убьёт данные при первой же записи?
Charging 12 часов без роста ёмкости это не норма. У LSI/Broadcom батарея обычно добирает 80-90 процентов за 2-4 часа, если она живая. Посмотри точные цифры: storcli /c0/bbu show all, поля Capacity и Relative State. Если Capacity стоит на месте, а Temperature в норме, скорее всего банки деградировали и контроллер их не берёт. Ещё проверь Design Capacity против текущей: просадка больше 30 процентов это уже приговор. Про WriteThrough: массив он поднимет, данные не убьёт, но каждая запись будет ждать подтверждения с диска, IOPS упадут в разы. Для одноразовой диагностики сойдёт, для продакшна нет. Учти ещё нюанс: некоторые контроллеры при Failed BBU сами уходят в WriteThrough, а в веб-морде это не всегда видно, надо смотреть Cache Policy в storcli. Если батарею менять, бери оригинальный артикул, совместимые аналоги часто не проходят калибровку и контроллер их просто игнорит.
Затык на fsck: пишут, что после простоя надо обязательно прогнать проверку, но не объясняют как понять, что она реально нужна, а не просто «на всякий случай». У меня сервер стоял три недели, ext4 вроде поднялся, mount без ошибок, а fsck показывает кучу осиротевших inode и предлагает почистить. Как отличить нормальную ситуацию от той, где лучше сначала снять ddrescue, чем соглашаться на автофикс? Это ведь как со старой машиной после зимы: завестись может и так, но постукивание в движке лучше послушать до поездки.
Ориентируйся на признак: если fsck запускается в read-only через ‘fsck -n /dev/sdX’, он показывает, что бы сделал, но ничего не меняет. Смотри на строки с ‘Inode N, i_blocks is …’ и на количество disconnected inodes. Пара штук после аварийного выключения это нормально, там перезапись журнала. Десятки и сотни, особенно со ссылками на директории, которых нет в дереве, означают, что журнал восстановился не полностью. В этом случае сначала ddrescue на отдельный диск, потом уже fsck с yes. Ещё момент: ext4 с ‘journal=ordered’ после простоя может тихо откатить часть незакоммиченных данных, mount это не покажет. Проверить, был ли откат, можно по dmesg: строки ‘EXT4-fs recovery completed’ и число replay-транзакций. Если больше одной, данные на границе журнала лучше считать потерянными. Для ZFS аналогично, но там сначала ‘zpool import -o readonly=on -N’, потом scrub вручную. И да, на ext4 xfs_repair не применим, для XFS порядок другой: сначала ‘xfs_repair -n’, но лог нельзя реплеить на ro-смонтированной ФС.