

Где на самом деле живут хосты Nginx Proxy Manager
Ты открыл Nginx Proxy Manager, добавил пять proxy hosts, всё работает. Потом решил посмотреть, где же лежат эти хосты. Идёшь в /etc/nginx/conf.d, там пусто или лежит один default.conf. Заходишь в /etc/nginx/sites-enabled, тоже ничего. Логично предположить, что интерфейс врёт, а Nginx здесь вообще не при делах. А потом приходит первый инцидент: ты пересоздаёшь контейнер без volume /data, и все хосты исчезают.
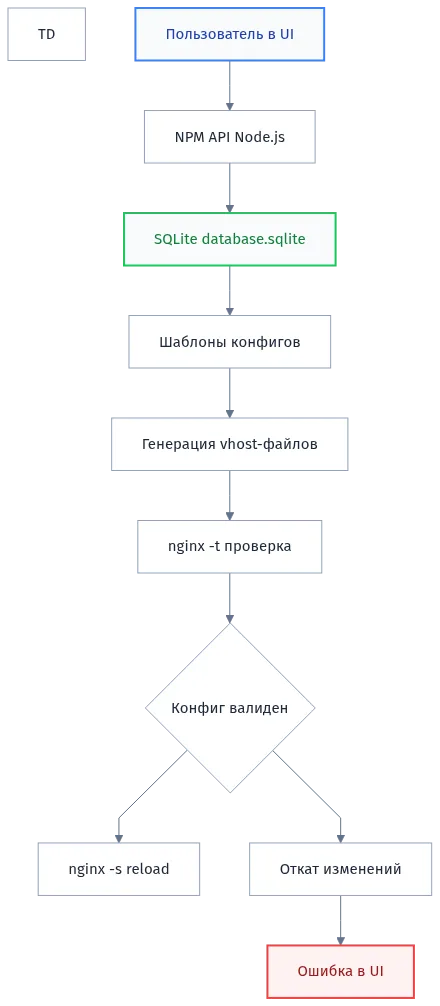
Под капотом Nginx Proxy Manager всё иначе, чем в классической настройке Nginx. Никаких ручных vhost-файлов, никаких symlinks в sites-enabled. Единственный источник истины это SQLite, а Nginx получает конфиги через автогенерируемые include. Если понимаешь этот поток, ты понимаешь:
- что именно бэкапить и почему только .conf файла недостаточно
- какие файлы внутри контейнера можно править руками, а какие перезапишутся
- как безопасно переехать на другой сервер без потери сертификатов и пользователей
- почему кривой custom config валит весь прокси, а не один хост
- как читать сгенерированный конфиг, чтобы понять, что реально видит Nginx
Что нужно на входе: работающий NPM в Docker, доступ к хосту с root или через sudo, и базовое умение читать nginx-конфиг. На разбор внутренностей и снятие корректного бэкапа уйдёт двадцать минут, если ты не станешь отвлекаться на переезд на другой сервер. На полный переезд с восстановлением сертификатов закладывай час, потому что LE rate limits и DNS-валидация не любят спешки.
Почему NPM идёт в обход конфигов Nginx
NPM построен вокруг идеи «GUI вместо vim». Если бы он писал статические файлы в /etc/nginx/conf.d, пришлось бы разруливать параллельную правку, откаты и синхронизацию состояния между интерфейсом и файловой системой. Разработчики пошли другим путём: база данных как единственный источник состояния, а Nginx-конфиг пересобирается заново на каждое изменение.
Отсюда несколько следствий, которые ломают привычные схемы сопровождения.
Причина 1. SQLite важнее, чем Nginx-конфиги
Конфиги Nginx в NPM это производная от базы. Если у тебя есть database.sqlite, ты поднимешь весь прокси даже с нуля на новом хосте. Если у тебя есть только сгенерированные conf-файлы, ты поднимешь Nginx, но потеряешь сертификаты, пользователей, аудит и логику роутинга. Их придётся восстанавливать руками, а часть данных уже недоступна.
Причина 2. Конфиги перезаписываются при каждом сохранении
Правишь ты proxy host через интерфейс, правит NPM через автоматику. Открываешь файл в /data/nginx/proxy_host/1.conf, дописываешь строчку, перезапускаешь контейнер: строчка исчезает. Всё потому что генератор берёт данные из SQLite и пересобирает файл с нуля. Ручные правки через файловую систему здесь не сохраняются, для них есть отдельные механизмы: Custom Nginx Configuration внутри хоста и Advanced-блок в Advanced-настройках.
Причина 3. Обновление контейнера без volume /data убивает всё
Самая частая история на форумах: человек ставит NPM через docker run без -v /path:/data, всё работает, потом обновляет образ через docker pull и docker rm старого контейнера. Новый контейнер стартует с чистой базой, потому что внутри образа /data это обычная директория, а не volume по умолчанию. Восстановить можно только из бэкапа, которого обычно нет.
Причина 4. Let’s Encrypt в NPM зависит от DNS и порта 80
Автоматическое SSL через HTTP-01 challenge требует, чтобы изнутри контейнера домен резолвился в тот же IP, что видит Let’s Encrypt, и чтобы порт 80 был доступен снаружи. Если у тебя DNS за Cloudflare в режиме Proxy, порт 80 снаружи закрывается, и challenge не проходит. Если A-запись смотрит на другой сервер, тот же результат.
Причина 5. Wildcard и HTTP-01 математически несовместимы
Wildcard-сертификат *.example.com нельзя выдать через HTTP-01, потому что ACME-сервер не знает, какой поддомен валидировать. Нужен DNS-01 с DNS-провайдером, который поддерживает автоматизацию через API. NPM умеет это для ограниченного набора провайдеров, и не для всех.
Причина 6. Ошибка в Custom Nginx Configuration роняет весь прокси
Ты дописал директиву в Advanced-табе одного хоста, там опечатка. NPM собирает все конфиги, делает nginx -t, тест валится, и NPM не применяет изменения, держа в кэше последний рабочий набор. Но если ты залез руками в /data/nginx/proxy_host/1.conf и перезапустил контейнер, Nginx прочитает битый файл и откажется стартовать. Тогда падает не один хост, а всё.
Причина 7. Порт 81 занят и админка не поднимается
NPM по умолчанию слушает 80 (HTTP-трафик), 81 (веб-интерфейс) и 443 (HTTPS). Если на хосте уже висит что-то на 81, контейнер стартует, Nginx на 80 и 443 поднимется, но админка недоступна. Со стороны выглядит как «NPM сломался», хотя по факту занят один порт.
Рецепт: разбираем NPM внутри и собираем корректный бэкап
Подготовка среды и что проверить до старта
Ничего ставить не будем, будем разбирать то, что уже есть. Понадобится:
- доступ к хосту по SSH с sudo
- установленный Docker Engine 24+ и docker compose plugin
- работающий контейнер NPM, желательно в compose-варианте
- свободное место под бэкап минимум в два размера тома /data
- понимание, где у тебя лежит docker compose файл и что в нём указано в разделе volumes
Первым делом посмотри, куда смонтирован /data в рабочем контейнере. Это ключевой момент: если там bind mount в /opt/npm/data, бэкапить нужно именно эту директорию хоста, а не что-то внутри образа.
# найти контейнер NPM
docker ps --format "table {{.Names}}\t{{.Image}}\t{{.Ports}}" | grep -i proxy

# посмотреть маппинг volume /data
docker inspect nginx-proxy-manager \
  --format '{{range .Mounts}}{{.Type}} {{.Source}} -> {{.Destination}}{{println}}{{end}}'
Ожидаемый результат: одна строка типа bind /opt/npm/data -> /data или volume npm_data -> /data. Запомни путь, он дальше везде подставляется вместо /opt/npm/data.
Таблица системных требований
| Компонент | Версия | Комментарий |
|---|---|---|
| ОС хоста | Ubuntu 22.04 / 24.04, Debian 12 | Проверялось на LTS-релиза, на других дистрибутивах пути те же |
| Docker Engine | 24.0 и выше | Нужен compose plugin или docker-compose v2 |
| Nginx Proxy Manager | 2.11.x и выше | Актуальная на момент написания, проверь релизы на странице проекта |
| SQLite | Идёт в образ NPM | Внутри контейнера, отдельно ставить не надо |
| Python для скрипта бэкапа | 3.10+ | Только если будешь использовать встроенную утилиту backup, а не копирование тома |
| Место на диске | 2x размер /data | Для бэкапа и временной копии при обновлении |
На момент публикации актуальна ветка NPM 2.x. Перед установкой или обновлением проверь свежие релизы на странице проекта в GitHub.
Таблица портов
| Порт | Протокол | Назначение | Доступен снаружи? |
|---|---|---|---|
| 80 | TCP | HTTP-трафик хостов, HTTP-01 challenge Let’s Encrypt | Да, обязательно для LE |
| 81 | TCP | Веб-интерфейс администратора | Ограничить по IP или спрятать за VPN |
| 443 | TCP | HTTPS-трафик хостов | Да |
| 443 | UDP | HTTP/3, если включён в NPM | Опционально |
Если 80 и 443 на хосте занимает другой nginx или Apache, NPM придётся либо слушать на других портах и проксировать, либо забирать порты освобождением. HTTP-01 без 80 не работает, DNS-01 работает.
Что внутри контейнера и за что отвечает
Заходим внутрь и смотрим структуру. Понимать её нужно, чтобы не бэкапить лишнее и не пропустить нужное.
docker exec -it nginx-proxy-manager bash

# далее уже внутри контейнера
ls -la /data
ls -la /data/nginx
ls -la /data/nginx/proxy_host 2>/dev/null
ls -la /data/letsencrypt 2>/dev/null
du -sh /data/*
Ожидаемый результат: в /data видишь database.sqlite, directory-structure под nginx, letsencrypt (если есть сертификаты), logs. В /data/nginx/proxy_host 2-3 конфига на каждый proxy host. Директория letsencrypt содержит архивы сертификатов Letsencrypt.
Разберём содержимое пофайлово:
| Путь | Что внутри | Бэкапить? |
|---|---|---|
| /data/database.sqlite | Хосты, пользователи, SSL-настройки, ACL | Да, обязательно |
| /data/nginx/proxy_host/*.conf | Сгенерированные конфиги proxy hosts | Да, но восстанавливается из базы |
| /data/nginx/redirection_host/*.conf | Redirection hosts | Да |
| /data/nginx/stream/*.conf | Stream-прокси, если используешь | Да |
| /data/nginx/dead_host/*.conf | Dead hosts, отдающие 404 | Да |
| /data/nginx/default_host/*.conf | Default host по умолчанию | Да |
| /data/nginx/maintenance/*.conf | Страницы техобслуживания | Да |
| /data/letsencrypt/ | Сертификаты и ключи Let’s Encrypt | Да, обязательно |
| /data/logs/ | Логи Nginx в разбивке по хостам | Опционально |
| /data/keys.json | JWT-ключи API и пользователей | Да, иначе сбросятся сессии |
| /data/mysql/ | Только для старой версии на MySQL, в 2.x не используется | Нет |
Ключевой вывод: бэкап одного database.sqlite уже даёт тебе 90 процентов восстановления, но без letsencrypt придётся перевыпускать сертификаты. При больших лимитах Let’s Encrypt это займёт время, а часть выпусков упрётся в rate limit.
Пошагово: как снять корректный бэкап
Простой, но рабочий способ: остановить контейнер, скопировать /data, запустить контейнер обратно. Он некрасивый, потому что на минуту кладёт весь прокси, зато исключает состояние «база пишется в момент копирования».
Начнём с мягкой проверки целостности базы до бэкапа. SQLite умеет это из коробки.
docker exec nginx-proxy-manager sqlite3 /data/database.sqlite "PRAGMA integrity_check;"
Ожидаемый результат: строка ok. Если что-то другое, бэкап ты уже снимаешь с повреждённой базы, лечи базу отдельно.
Дальше снимаем копию без остановки контейнера, через SQLite online backup API. Это безопаснее, чем cp, и не блокирует API NPM.
# создать директорию под бэкап с датой
mkdir -p /opt/backups/npm/$(date +%Y-%m-%d)

# через docker exec запустить .backup прямо в примонтированный каталог
docker exec nginx-proxy-manager sqlite3 /data/database.sqlite \
  ".backup '/data/backup/database-$(date +%F-%H%M).sqlite'"
Чтобы .backup писал куда нужно, заранее примонтируй бэкап-директорию в контейнер. В compose добавь в volumes строку /opt/backups/npm:/data/backup. Если монтировать не хочешь, копируй при остановленном контейнере через docker cp.
# вариант с остановкой для холодного бэкапа
docker stop nginx-proxy-manager
tar -czf /opt/backups/npm/npm-data-$(date +%F-%H%M).tar.gz \
  -C /opt/npm data
docker start nginx-proxy-manager
Ожидаемый результат: в /opt/backups/npm появляется .tar.gz или .sqlite с текущей датой. Размер архива обычно от единиц до сотен мегабайт, в зависимости от количества сертификатов.
Архитектура взаимодействия компонентов
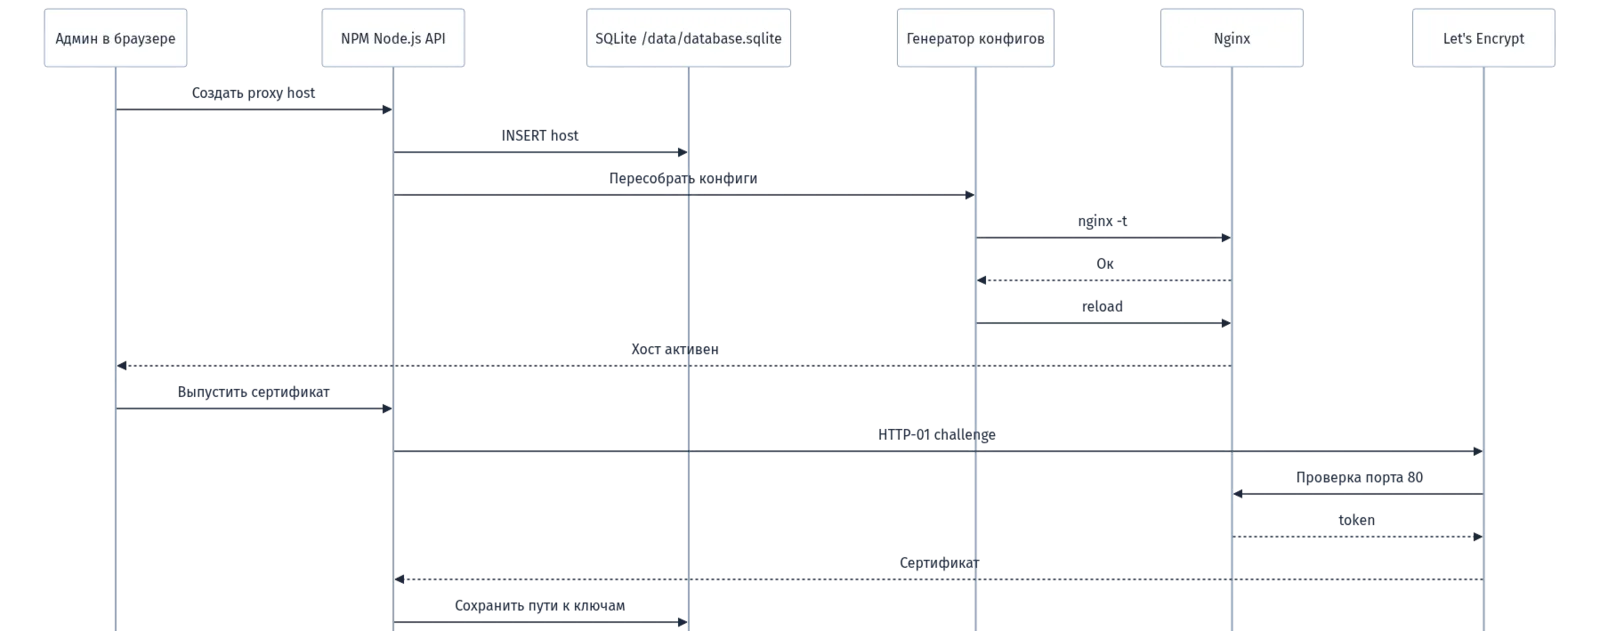
Смотри на поток: любой чих в интерфейсе проходит через базу, затем через генератор, и только потом доходит до Nginx. Никакого прямого редактирования vhost-файлов тут нет.
Безопасность на этапе настройки
Три вещи, которые надо закрыть сразу, а не «потом».
Первая: админка на 81 порту не должна смотреть в интернет. Открой её либо через VPN, либо через firewall с whitelist IP.
# UFW: разрешить 81 только офисному диапазону
sudo ufw allow from 203.0.113.0/24 to any port 81 proto tcp
sudo ufw deny 81/tcp
sudo ufw status numbered
Ожидаемый результат: в списке ufw три правила: allow for 203.0.113.0/24 to any port 81, deny 81/tcp, плюс стандартные 80 и 443. Все остальные адреса получают connection refused на 81.
Вторая: смени дефолтный логин admin@example.com с паролем changeme при первом входе. NPM сам просит это сделать, но некоторые откладывают и забывают. Пароль длиной от 16 символов, храни в менеджере паролей, не в стикере на столе.
Третья: файл database.sqlite и /data/letsencrypt содержат чувствительные данные, включая приватные ключи. Права на каталог /opt/npm/data должны быть 700 root или владельца-сервисной учётки, никаких 777 и никаких world-readable. Проверить это надо до того, как ты передашь бэкап по сети.
sudo chown -R root:root /opt/npm/data
sudo chmod 700 /opt/npm/data
sudo chmod 600 /opt/npm/data/database.sqlite
ls -ld /opt/npm/data /opt/npm/data/database.sqlite
Ожидаемый результат: drwx—— для /data и -rw——- для базы. Если NPM запускается от непривилегированного пользователя внутри контейнера, ты владельца не меняй, а подгони под UID из образа.
Как заглянуть в сгенерированный конфиг и не сломать его
Смотреть нужно. Править нельзя без понимания последствий. Открой файл конкретного хоста и посмотри, куда NPM ведёт трафик, какие заголовки добавляет, как обрабатывает SSL.
# зайти в контейнер и посмотреть конфиг первого хоста
docker exec -it nginx-proxy-manager bash
cat /data/nginx/proxy_host/1.conf
ls /data/nginx/proxy_host/
Ожидаемый результат: блоки server с listen 80 и listen 443 ssl, в директиве ssl_certificate пути из /data/letsencrypt/live/… , в location / proxy_pass на upstream из твоей конфигурации proxy host. Заголовки X-Forwarded-For, X-Forwarded-Proto, X-Real-IP должны быть на месте, иначе приложения за NPM будут видеть IP контейнера вместо клиента.
Ещё одна полезная вещь: посмотреть карту всех хостов и их id одним запросом к базе. Это спасает в диагностике: видно, какие домены где живут и нет ли дубля Server Name.
docker exec nginx-proxy-manager sqlite3 -header -column /data/database.sqlite \
  "SELECT id, domain_names, forward_host, forward_port, enabled FROM proxy_host;"
Ожидаемый результат: таблица со столбцами id, domain_names, forward_host, forward_port, enabled. Если домен встречается в двух строках, готовься к тому, что Nginx будет использовать первый совпавший server block, а второй просто не отработает.
Откат, если что-то пошло не так
До любых экспериментов с базой сделай снимок. Не «потом», а сейчас, прямо перед тем, как нажать «сохранить» в интерфейсе на опасной правке.
# снимок базы через online backup
docker exec nginx-proxy-manager sqlite3 /data/database.sqlite \
  ".backup '/data/backup/pre-change-$(date +%F-%H%M).sqlite'"
План откат: останови контейнер, замени /data/database.sqlite снимком, запусти контейнер. Никаких параллельных правок в веб-интерфейсе в это время быть не должно, иначе последние изменения потеряются.
docker stop nginx-proxy-manager
sudo cp /opt/backups/npm/pre-change-2025-01-15-1200.sqlite /opt/npm/data/database.sqlite
docker start nginx-proxy-manager
Ожидаемый результат: интерфейс открывается, те же хосты, что были в момент снимка. Сертификаты на месте, потому что /data/letsencrypt не трогали.
Проверка: убеждаемся, что всё живо и делает то, что мы думаем
Проверка не «открыл браузер и увидел зелёный замок». Проверка это набор команд, каждая из которых отвечает на конкретный вопрос.
Хосты и база согласованы
# сколько хостов в базе
docker exec nginx-proxy-manager sqlite3 /data/database.sqlite \
  "SELECT COUNT(*) FROM proxy_host WHERE enabled = 1;"

# сколько сгенерированных конфигов
docker exec nginx-proxy-manager bash -c "ls -1 /data/nginx/proxy_host/*.conf | wc -l"
Ожидаемый результат: оба числа совпадают или отличаются не более чем на единицу. Если в базе 12, а файлов 15, значит есть осиротевшие конфиги от ранее удалённых хостов. Не страшно, но полезно подчистить, чтобы в grep по логам не путаться.
Nginx реально принял конфиг
docker exec nginx-proxy-manager nginx -t
docker exec nginx-proxy-manager nginx -T 2>/dev/null | grep -c "server_name"
Ожидаемый результат: syntax is ok, test is successful. Второй командой посчитали, сколько директив server_name видит Nginx в итоговом конфиге со всеми include. Число должно быть не меньше, чем количество твоих хостов: NPM добавляет свои служебные блоки.
Трафик ходит и приложение видит реальный IP
# локально
curl -I https://app.example.com

# снаружи (с другой машины)
curl -sv https://app.example.com 2>&1 | grep -E "HTTP/|server:"

# проверить, что upstream видит реальный IP клиента
curl -H "X-Forwarded-For: 203.0.113.7" https://app.example.com/whoami
Ожидаемый результат: HTTP/2 200, заголовок server от Nginx из контейнера, приложение в ответе на /whoami показывает 203.0.113.7, а не 172.18.0.x. Если показывает внутренний IP контейнера, значит заголовки X-Forwarded-For не доходят, и в приложении надо включить trust proxy.
Сертификаты на месте и не истекают завтра
# проверить даты и SAN сертификата
echo | openssl s_client -connect app.example.com:443 -servername app.example.com 2>/dev/null \
  | openssl x509 -noout -dates -subject -ext subjectAltName
Ожидаемый результат: notAfter как минимум на 60 дней вперёд, subject и SAN совпадают с текущим доменом. Если осталось меньше 30 дней и NPM не перевыпускает сертификат, значит автоматическое обновление не срабатывает по какой-то причине, обычно это блокировка порта 80 снаружи или проблема с DNS.
Порты слушают то, что мы думаем
sudo ss -tulpn | grep -E ":(80|81|443)\b"
docker exec nginx-proxy-manager ss -tulpn | grep -E ":(80|81|443)\b"
Ожидаемый результат на хосте и внутри контейнера: три порта на LISTEN, привязанные к docker-proxy или к Nginx из контейнера. Если порт 81 на хосте занят другим процессом, ты это тут и увидишь.
База проходит integrity check после бэкапа
docker exec nginx-proxy-manager sqlite3 /data/backup/pre-change-2025-01-15-1200.sqlite "PRAGMA integrity_check;"
Ожидаемый результат: ok. Если что-то другое, твой бэкап битый, восстанавливать из него нечего, снимай заново, пока исходная база ещё жива.
Когда всё сломалось: разбор типовых ошибок Nginx Proxy Manager
Ты уже знаешь, где лежит SQLite база данных Nginx Proxy Manager и как устроен поток данных от proxy hosts до сгенерированного конфига Nginx. Теперь разберём, что делать, когда оно перестало работать. Симптомы у всех похожие, причины разные.
Ниже разбор по принципу «ошибка, причина, решение, команда». Проверяй по порядку, не перескакивай. Девяносто процентов инцидентов с NPM закрываются на первых трёх строчках.
502 Bad Gateway на всех хостах сразу
Симптом: открываешь любой домен, NPM отдаёт 502. Веб-морда на порту 81 живая, хосты отображаются, но трафик не идёт.
Причина почти всегда одна из двух. Либо backend-контейнер с приложением лежит, либо NPM потерял сетевую видимость до него. Второе типично после пересоздания Docker-сети или если ты подключил NPM к нескольким сетям и поменял маршрутизацию.
Сначала проверь, поднят ли backend.
docker ps --format "table {{.Names}}\t{{.Status}}\t{{.Ports}}"
Если контейнер приложения работает, смотри, видит ли его NPM по имени. Заходи внутрь NPM и пробуй резолвить и дергать backend напрямую.
docker exec -it nginx-proxy-manager sh
getent hosts app-backend
curl -I http://app-backend:8080
Если getent не резолвит имя, контейнеры в разных сетях. Подключи оба к общей сети.
docker network connect npm-internal app-backend
docker restart nginx-proxy-manager
Если имя ресолвится и curl отвечает 200, а снаружи всё равно 502, значит NPM держит старый сгенерированный конфиг. Форсируй регенерацию, изменив любой хост в веб-морде, либо перезапусти контейнер. Смотри на результат.
Let’s Encrypt не выдаёт сертификат
Симптом: жмёшь Request Certificate, через минуту красная плашка с ошибкой валидации.
Причина зависит от метода challenge. Для HTTP-01 Let’s Encrypt должен достучаться до /.well-known/acme-challenge/ на твоём домене через 80 порт. Если порт закрыт снаружи фаерволом, если домен резолвится не на твой IP, если CDN перехватывает трафик, валидация падает.
Проверь три вещи по порядку. Первое, разрешение домена снаружи.
dig +short your.domain.com
curl -I http://your.domain.com/.well-known/acme-challenge/test
Второе, доступность 80 порта с внешней машины, не с самого сервера.
nc -zv your.domain.com 80
Третье, логи NPM. Ошибки ACME там лежат явно и с причиной.
docker logs nginx-proxy-manager 2>&1 | grep -i acme | tail -50
Не забывай про лимиты Let’s Encrypt. Пять неудачных валидаций в час на домен, и ты в таймауте. Пока не разберёшься с причиной отказов, не жми повторно, только усугубишь. Для wildcard-сертификата HTTP-01 не сработает вообще, там нужен DNS-01 challenge с API-ключом DNS-провайдера.
Конфликт Server Name между хостами
Симптом: два proxy host с одинаковым именем домена, работают как повезёт, иногда трафик уходит не туда.
Причина простая. Nginx при дублировании server_name в нескольких server-блоках использует первый совпавший, остальные игнорирует. NPM при этом не ругается и конфиг генерирует без ошибок. Ты просто получаешь непредсказуемое поведение.
Посмотри сгенерированные конфиги и найди дубли по имени.
docker exec -it nginx-proxy-manager sh
grep -rn "server_name" /data/nginx/proxy_host/
grep -rn "server_name" /data/nginx/redirection_host/
Нашёл дубликаты, удаляй лишние proxy host через веб-морду, не правь файлы руками. После удаления проверь, что в базе не осталось висяков.
SELECT id, domain_names, enabled FROM proxy_host WHERE domain_names LIKE '%your.domain.com%';
Домен может фигурировать и в proxy host, и в redirection host одновременно. Это тоже конфликт. Оставь только то, что реально нужно.
Порт 81 занят, веб-интерфейс не открывается
Симптом: NPM поднялся, контейнер в статусе Up, но админка на 81 не отвечает.
Причина: порт занят другим процессом на хосте или маппинг в docker-compose кривой. Проверь, кто держит порт.
ss -tulpn | grep :81
lsof -i :81
Если это не NPM, освобождай порт или меняй маппинг. В compose-файле поменяй левую часть, внешний порт, на свободный.
ports:
  - "8081:81"
  - "80:80"
  - "443:443"
После смены маппинга админка будет на 8081, внутренний порт NPM остаётся 81. Не перепутай, приложение внутри контейнера слушает именно 81.
Правка Custom Nginx Configuration уронила весь прокси
Симптом: добавил пару строк в Custom Nginx Configuration одного хоста, после сохранения умерли все домены, включая админку.
Причина: конфиг этого хоста встраивается в общий nginx.conf как include. Синтаксическая ошибка в одном файле валит парсинг всего конфига, Nginx не стартует или падает на reload. Ошибка локального хоста становится глобальной аварией.
Проверь синтаксис прямо внутри контейнера.
docker exec -it nginx-proxy-manager nginx -t
В выводе будет файл и строка с ошибкой. Ищи в /data/nginx/proxy_host/ соответствующий конфиг, смотри, что ты туда вписал. Часто это забытая точка с запятой, непарная фигурная скобка или неверная директива.
Быстрый способ вернуть прод в строй: убери кастомный блок через веб-морду, если она ещё жива. Если админка тоже недоступна, правь файл напрямую и перезагружай.
docker exec -it nginx-proxy-manager sh
sed -n '1,50p' /data/nginx/proxy_host/5.conf
# после правки
nginx -t && nginx -s reload
Правило простое. Кастомные конфиги тестируй на стейдже, и никогда не вписывай туда эксперименты, которые не проверил через nginx -t.
Альтернативы Nginx Proxy Manager: Traefik и Caddy
NPM удобен, но его модель «SQLite плюс генератор конфигов» не всем подходит. Если хостов сотни, если нужен полный GitOps, если конфиг должен версионироваться в репозитории, ты упрёшься в потолок.
| Критерий | Nginx Proxy Manager | Traefik | Caddy |
|---|---|---|---|
| Хранение конфигурации | SQLite в /data | Метки в Docker или файлы | Caddyfile или API |
| Интерфейс | Веб-морда | Dashboard, опционально | Только конфиг |
| Автовыпуск сертификатов | Да, через UI | Да, автоматически | Да, автоматически |
| Динамическая конфигурация | Только через UI или БД | Из labels и провайдеров | Через API и reload |
| Порог входа | Низкий | Средний | Средний |
| Идеальный сценарий | Хоумлаб, малый бизнес | Микросервисы, Kubernetes | Простые статические конфиги |
Traefik выигрывает там, где сервисы появляются и исчезают каждую минуту. Он читает метки Docker в реальном времени, конфиг генерировать руками не надо. Для Docker Swarm и Kubernetes это родная среда. Минус в том, что без опыта метки превращаются в кашу, а дебаг маршрутизации сложнее, чем посмотреть файл в NPM.
Caddy берёт другим. Конфиг читается человеком, автоматом выпускает и обновляет сертификаты без всяких challenge-танцев. Две строки, и HTTPS работает. Для статического парка доменов это самый быстрый старт. Но динамику Caddy не любит, каждый новый хост требует правки конфига и reload.
Почему в хоумлабе и малом бизнесе чаще берут NPM: веб-морда, порог входа почти нулевой, весь конфиг виден в UI. Для пяти-двадцати хостов это оптимум. Как только домены пойдут десятками и потребуется автоматизация, начинается миграция в сторону Traefik.
Профилактика: бэкап, мониторинг, безопасность, обновления
Инженер, который один раз потерял volume NPM с двумя десятками сертификатов, бэкапы настраивает до того, как что-то сломается. Тут этап профилактики, и он самый важный.
Что бэкапить в NPM и как часто
Единственный источник истины во всей системе это каталог /data. Внутри него живёт SQLite база, сгенерированные конфиги Nginx, сертификаты Let’s Encrypt и приватные ключи. Без него восстановление хостов невозможно: статический файл конфига Nginx тебе ничего не даст, потому что NPM его перегенерирует из базы при старте.
Бэкап делай на уровне каталога, не через дамп только базы. Дамп базы не захватит сертификаты и приватные ключи, а их восстановление с нуля означает новые выдачи от Let’s Encrypt и попадание в лимиты.
docker run --rm \
  -v npm_data:/data \
  -v /backup/npm:/backup \
  alpine tar czf /backup/npm-$(date +%F-%H%M).tar.gz -C /data .
Перед архивированием останови контейнер NPM на пару секунд, чтобы SQLite не писал в базу во время копирования. Иначе рискуешь получить битый файл базы.
docker stop nginx-proxy-manager
docker run --rm -v npm_data:/data -v /backup/npm:/backup alpine \
  tar czf /backup/npm-$(date +%F).tar.gz -C /data .
docker start nginx-proxy-manager
Частота: раз в сутки автоматически через cron, плюс вручную перед каждым обновлением контейнера и перед массовыми правками хостов. Хранение: минимум две копии, одна локально, одна на другом хосте или в объектном хранилище. Локальная копия рядом с прод-сервером не считается бэкапом, диск сдохнет вместе с ней.
Восстановление: останавливаешь контейнер, разворачиваешь архив в пустой volume, стартуешь.
docker stop nginx-proxy-manager
docker run --rm -v npm_data:/data -v /backup/npm:/backup alpine \
  sh -c "rm -rf /data/* && tar xzf /backup/npm-2025-01-15.tar.gz -C /data"
docker start nginx-proxy-manager
После старта зайди в админку и проверь, что все хосты, сертификаты и пользователи на месте. Если что-то пропало, значит архив собран после частичного сбоя базы, используй предыдущую копию.
Мониторинг состояния NPM
Мониторить надо три вещи: доступность админки, доступность проксируемых хостов снаружи и срок жизни сертификатов. Без этого узнаёшь о проблеме от пользователей.
Простейший healthcheck для админки через curl с проверкой кода ответа.
curl -sf -o /dev/null -w "%{http_code}\n" http://127.0.0.1:81/api/
Код 200 или 401 значат, что API живой. 000 значит, контейнер не отвечает. Это вешай в Zabbix, Prometheus blackbox exporter или любой другой мониторинг, который у тебя уже есть.
Для сертификатов отслеживай дату истечения через openssl. Скрипт ниже забирает notAfter, дальше сравнение с порогом в днях, и алерт срабатывает за 14 дней до конца.
echo | openssl s_client -servername your.domain.com -connect your.domain.com:443 2>/dev/null \
  | openssl x509 -noout -dates
Проверка хостов снаружи важнее внутренней. NPM внутри может быть здоров, но фаервол на хосте или у провайдера закроет 443, и ты об этом не узнаешь. Ставь внешнюю проверку с отдельной машины.
Безопасность: что закрыть в первую очередь
Порт 81 снаружи открывать нельзя. Админка NPM торчит в интернет только в случае, когда ты сам этого не понимаешь. Заверни её за VPN, за SSH-туннель, либо ограничь доступ по IP.
sudo ufw allow from 203.0.113.10 to any port 81 proto tcp
sudo ufw deny 81/tcp
sudo ufw reload
Смени пароль администратора сразу после установки. Дефолтный admin@example.com со сменой при первом входе ещё не значит, что пароль сильный. Ставь менеджер паролей, генерируй 24 символа.
NPM ходит наружу за сертификатами и, если настроен Access List, работает с LDAP и базовой аутентификацией. Изолируй его в отдельную Docker-сеть, не подключай к произвольным подсетям. Файлы с ключами Let’s Encrypt лежат в /data/tls/, права на каталог только для root и для пользователя контейнера.
Fail2ban на уровне хоста прикручивается к логам NPM. Логи внутри контейнера забирает Docker и отдаёт в journald или в файл, оттуда читает fail2ban и банит IP по частоте 401 на /api/tokens.
Безопасное обновление и откат
Обновление NPM это смена тега образа и пересоздание контейнера. Схема базы SQLite может меняться от релиза к релизу, а значит откат на старый тег без бэкапа не сработает. Поэтому порядок строгий.
Сначала бэкап volume. Потом фиксируешь текущий тег образа, к которому сможешь вернуться. Затем подтягиваешь новый образ и пересоздаёшь контейнер. После старта проверяешь логи и вход в админку.
docker stop nginx-proxy-manager
docker run --rm -v npm_data:/data -v /backup/npm:/backup alpine \
  tar czf /backup/npm-preupgrade-$(date +%F).tar.gz -C /data .
docker pull jc21/nginx-proxy-manager:latest
docker compose up -d
docker logs -f nginx-proxy-manager
Если после обновления админка не открывается или хосты отдают 502, откат такой: останавливаешь контейнер, возвращаешь старый тег в compose, разворачиваешь бэкап volume, стартуешь.
docker compose down
docker run --rm -v npm_data:/data -v /backup/npm:/backup alpine \
  sh -c "rm -rf /data/* && tar xzf /backup/npm-preupgrade-2025-01-15.tar.gz -C /data"
# в docker-compose.yml верни предыдущий тег
docker compose up -d
На момент публикации актуальна версия NPM 2.17.0. Перед установкой проверь свежие релизы в официальном репозитории проекта.
| Компонент | Минимальная версия | Примечание |
|---|---|---|
| ОС | Ubuntu 22.04 / Debian 12 | Любой дистрибутив с Docker 24+ |
| Docker Engine | 24.0 | Проверяй, что compose v2 |
| NPM | 2.11 | Схема базы мигрирует автоматически |
| SQLite | 3.40+ | Внутри образа, вручную не ставится |
FAQ: частые вопросы про Nginx Proxy Manager
Формулировки ниже взяты так, как пользователи реально спрашивают в поиске. Если твоего случая тут нет, смотри логи и разбирай по той же схеме.
Почему Nginx Proxy Manager не работает после настройки? Чаще всего потому, что контейнер не видит backend-приложение по сети, либо дублируется server_name в нескольких хостах. Проверь docker exec внутрь NPM и резолв имени backend, затем поиск конфликта в базе. Ещё вариант: конфиг не регенерировался, измени любой хост или перезапусти контейнер.
Как проверить, что NPM работает правильно? Снаружи проверь, что на 80 и 443 отвечает Nginx, что сертификат отдаётся верный, а админка на 81 доступна только тебе. Команда curl -I https://your.domain.com должна вернуть 200 или код твоего приложения, а openssl s_client покажет актуальную дату истечения. Изнутри убедись, что nginx -t не ругается.
Что делать, если выдалась ошибка Let’s Encrypt? Смотри лог docker logs nginx-proxy-manager | grep acme и из него определяй причину. Для HTTP-01 проверь, что порт 80 доступен снаружи и домен резолвится на твой IP. Если только что делал несколько неудачных попыток, подожди час, лимит Let’s Encrypt 5 отказов на домен в час.
Чем NPM отличается от Traefik и Caddy? NPM хранит конфигурацию в SQLite и управляется через веб-интерфейс, что удобно для малого числа хостов. Traefik динамически читает метки Docker и хорош для микросервисов. Caddy минималистичен, конфигурируется файлом и сам выпускает сертификаты без UI. Для хоумлаба NPM порог входа ниже.
Какой файл бэкапить в Nginx Proxy Manager? Каталог /data целиком: database.sqlite и всё содержимое nginx/, tls/, letsencrypt/. Только база без сертификатов означает, что после восстановления придётся выпускать сертификаты заново и попадать в лимиты. Только конфиги Nginx без базы бесполезны, они генерируются из базы при старте.
Что будет, если удалить volume Nginx Proxy Manager? Потеряются все proxy hosts, сертификаты, пользователи, настройки Access List и логи. NPM поднимется с чистой базой, как при первой установке, и попросит создать администратора. Восстановление возможно только из бэкапа каталога /data. Файлы конфигов Nginx, сгенерированные ранее, тоже исчезнут.
Что теперь работает и что делать дальше
После этих шагов у тебя есть разбор внутренностей NPM: понимание, где живёт база, как генерируются конфиги, что ломается и почему. Ты знаешь, что бэкапить, как восстанавливать и куда смотреть, когда что-то отдаёт 502. Это фундамент, на котором лежит вся эксплуатация прокси.
Ещё ты знаешь, что NPM не единственный вариант. Дальше выбор за тобой: остаёшься на простом UI или уходишь в Traefik, когда хостов станет больше десятка. Обязательная часть независимо от выбора: регулярный бэкап /data, закрытая админка, автопроверка сертификатов.
nginx -t, фрагмент логов ACME. Разберём конкретный случай, без гипотез по фотографии экрана.
Author: Андрей А.
25 years in IT — from a field engineer at MegaFon to head of department. I rebuild IT infrastructure that’s falling apart and turn it into something predictable. I know what chaos costs. I help businesses get out of a crisis: cleaning up legacy systems, stabilizing what’s breaking, and setting up processes you can actually plan around.
Оставайтесь на связи
Рецепты от IT-боли. Без воды, без рекламы, без маркетинговой шелухи.
Подписаться на IT-Аптеку →

Столкнулся с тем, что при переезде на другую машину сертификаты Let’s Encrypt через копирование /data не поднимаются. Точнее, файлы на месте, а NPM при старте ругается на несовпадение отпечатков или просто игнорирует их, и в интерфейсе SSL становится пустым. При этом на одном сервере всё ок, а как только появляется реплика или второй инстанс за балансировщиком, начинаются грабли с конкурентной записью в SQLite. Интересно, как у тебя устроен процесс при горизонтальном масштабировании: ты выносишь базу на отдельный volume и монтируешь read-only, или гоняешь активный/пассивный через переключение DNS? И что происходит с генерацией конфигов, если два контейнера одновременно смотрят в один и тот же /data?
Реплика с общим /data действительно ломается, и вот почему. SQLite в NPM открывается в journal_mode=DELETE, без WAL, поэтому два процесса на общем томе получают блокировку базы и падают с SQLITE_BUSY на первой же записи через веб-интерфейс. Генератор конфигов в этот момент тоже пишет в /data/nginx, так что второй инстанс может затереть файлы первого. Проверить это просто: docker exec в контейнер, sqlite3 /data/database.sqlite ‘PRAGMA journal_mode;’ покажет delete, а lsof на database.sqlite из двух контейнеров виден как два открытых дескриптора.
Рабочая схема для нескольких машин это активный и пассивный инстанс, переключение через DNS или keepalived. Бэкап снимается с активного, пассивный держит копию тома и поднимается после смены A-записи. Если очень нужен второй живой инстанс, выносить SQLite на сетевую ФС нельзя, NPM не умеет работать с блокировками по NFS. Сертификаты при переезде переносятся вместе с /data/letsencrypt, но проверь, что в /data/keys.json лежат те же ключи, иначе сессии и API-токены сбросятся. Перед сменой активного прогони nginx -t внутри контейнера и убедись, что сгенерированные конфиги валидны, иначе пассивный стартанёт с битым набором.
Восстанавливал NPM из бэкапа тома, но база оказалась битой: копировал /data через rsync на живой системе, без остановки. Спасли старый снапшот из теневой копии. Теперь всегда делаю docker stop перед копированием. Вопрос: как правильно бэкапить /data без простоя, есть ли способ безопасно снять дамп sqlite и не потерять согласованность с генератором конфигов?
Да, простой способ есть: останови контейнер, но не весь, а только NPM, затем скопируй том. Если простой критичен, используй sqlite3 .backup. Зайди в контейнер: docker exec -it npm sqlite3 /data/database.sqlite ‘.backup /tmp/npm-backup.sqlite’, потом скопируй файл из /tmp. Важно: этот дамп снимает согласованный снимок базы, даже если в неё пишут. Параллельно с ним забирай папку /data/letsencrypt целиком, иначе сертификаты придётся перевыпускать. После восстановления запусти NPM с volume, чтобы не потерять изменения. Генератор конфигов NPM читает базу при старте и при каждом сохранении через UI, так что рассинхрон возможен только если ты правишь .conf руками во время дампа, но такие правки всё равно перезапишутся. Проверить целостность восстановленной базы можно запросом sqlite3 /data/database.sqlite ‘PRAGMA integrity_check;’, ожидаемое значение ok.
Застрял на моменте с бэкапом. Если я просто скопирую папку /data через cp, пока контейнер работает, что реально может сломаться в базе? И как потом проверить, что копия живая, а не битая, до того как я снесу рабочий контейнер и попробую поднять из неё новый?
Копирование работающей SQLite через cp опасно не самой базой, а моментом: если в этот момент идёт запись (сохранение хоста, выпуск сертификата), файл может быть скопирован в состоянии journal или WAL, где часть транзакций ещё не применена к основному файлу. На выходе получишь database.sqlite, который формально открывается, но при `PRAGMA integrity_check` выдаст ошибки или потеряет часть записей. Чтобы проверить копию без риска: `sqlite3 /путь/копии/database.sqlite ‘PRAGMA integrity_check;’` должен вернуть `ok`, плюс `PRAGMA foreign_key_check;`. Ещё полезно сравнить количество строк в ключевых таблицах: `SELECT COUNT(*) FROM proxy_host;` и то же для user, certificate. Если хочешь копировать без остановки контейнера, есть более безопасный путь: `sqlite3 /data/database.sqlite «.backup ‘/backup/database.sqlite'»` внутри работающего контейнера, эта команда делает консистентный снимок через API самой SQLite и не боится параллельной записи. Дальше отдельно копируешь /data/letsencrypt и /data/keys.json. Проверку восстановления делай на отдельной машине или в отдельной docker-сети, чтобы не конфликтовать по портам 80/81/443 с боевым NPM.
Разбирался с бэкапом и застрял вот на чём. У меня /data это именованный docker volume, а не папка на хосте. То есть в docker-compose стоит npm_data:/data, и на сервере я не могу просто зайти в /opt/npm/data и сделать cp -r. Как правильно вытащить базу и сертификаты из именованного тома, чтобы потом восстановить на новой машине? Пробовал docker cp из живого контейнера, но подозреваю, что SQLite в этот момент пишется в WAL и копия может быть битой. И ещё не понимаю: если я переезжаю на другой сервер и переношу том, надо ли что-то менять в compose, или достаточно, чтобы путь монтирования внутри контейнера остался /data? Хочу именно надёжный сценарий, а не народный способ на удачу.
С именованным томом есть два рабочих варианта. Первый: остановить контейнер (docker compose stop), потом короткая команда через вспомогательный контейнер: docker run —rm -v npm_data:/data -v $(pwd):/backup alpine tar czf /backup/npm_data.tar.gz -C /data . Это надёжнее docker cp, потому что tar читает согласованное состояние, когда NPM уже не пишет. Насчёт SQLite ты прав: NPM держит базу в WAL-режиме, рядом с database.sqlite будут лежать database.sqlite-wal и database.sqlite-shm. При копировании на живую их нужно брать все три, иначе потеряешь последние транзакции. Проще не копировать на живую. Второй момент: путь монтирования внутри контейнера менять нельзя, точка монтирования жёстко прописана в образах NPM и entrypoint ждёт /data. На новом хосте в compose можешь спокойно указать npm_data:/data заново, Docker создаст пустой том, а ты распакуешь туда архив тем же tar через alpine. Проверка после переноса: docker exec -it npm sh -c ‘ls -la /data && sqlite3 /data/database.sqlite «select count(*) from proxy_host;»‘ должно вернуть твои хосты. И да, сними бэкап до смены версии образа, а не после, потому что миграции схемы идут при старте и откатить их сложнее.