

Домашний сервер без бэкапа: где именно ты это обнаружишь
Резервное копирование домашнего сервера делают почти все. Проверяют восстановление почти никто. Итог обычно виден в самый неподходящий момент: диск сыпет relocate sectors, ты достаёшь архив недельной давности, разворачиваешь, а Nextcloud стартует с пустой базой, сервисы падают с permission denied, Proxmox не видит загрузчик. Данные вроде на месте, а система нерабочая.
Вот тут важно понять одну вещь. Бэкап это артефакт, который можно восстановить. Всё остальное это копия файлов, которая при первом же реальном восстановлении покажет обратное. Ниже разберу, что копировать с домашнего сервера, какими флагами, как получать согласованный снимок баз и виртуалок, и как проверить, что бэкап живой.
Что получишь по итогу:
- понимание, что именно нельзя копировать живым файлом: СУБД, диски ВМ, открытые файлы;
- рабочий скрипт rsync с флагами, которые сохраняют права, ACL, xattr, жесткие ссылки и разреженные файлы;
- алгоритм получения снапшота ZFS/Btrfs/LVM или дампа через pg_dump, mysqldump, vzdump;
- команды проверки целостности через sha256 и тестовое восстановление;
- схему 3-2-1 под домашний бюджет без покупки NAS за 80 тысяч.
Время на настройку: от 40 минут на первый скрипт, до выходного, если у тебя Proxmox с виртуалками. Что нужно: root-доступ, отдельный диск или внешний сторедж, свободное место под бэкап минимум вдвое больше сжатого объёма данных.
Почему бэкап домашнего сервера разваливается при восстановлении
Причины, которые я видел вживую чаще всего. Все они не про то, что копирование не запустилось. Копирование как раз проходит. Ломается восстановление.
Живые файлы базы данных копируются в промежуточном состоянии
PostgreSQL, MySQL, MongoDB держат буферы в памяти и пишут на диск асинхронно. Файлы .ibd, pg_wal, журналы Mongo в момент копирования внутренне несогласованны. rsync честно скопирует все байты, но получится не база, а конструкция из файлов, которые на месте не собираются. Восстановление падает на этапе старта СУБД, лог покажет повреждение page header. Нужен либо дамп через pg_dump/mysqldump, либо снапшот ФС до начала копирования.
ВМ Proxmox в бэкапе без снапшота
Если ты копируешь /var/lib/vz/images/ целиком, файл .raw или .qcow2 на работающей ВМ снят из состояния, в котором гость пишет прямо сейчас. Файловая система внутри диска не закрыта, журнал ext4 не применён. После восстановления ВМ либо не грузится, либо грузится и падает в fsck с предложением починки, которая половину Inode съедает.
Для согласованности нужен режим snapshot: ZFS, LVM-thin или Ceph в Proxmox VE. Для стореджей, которые снапшоты не поддерживают, vzdump по умолчанию уходит в режим stop, ВМ останавливается, потом снимается дамп. Режим suspend даёт согласованность только при наличии qemu-guest-agent внутри гостя.
LXC без fsfreeze в дампе
Контейнер LXC это не ВМ. Снапшот хранилища сам по себе не гарантирует, что приложения внутри контейнера закрыли транзакции. Нужен предварительный fsfreeze на корневой ФС контейнера через pct fsfreeze, иначе PostgreSQL внутри LXC в дампе будет с незакрытым WAL.
rsync без правильных флагов ломает метаданные
Копирование через rsync -av без -A -X не сохраняет POSIX ACL и расширенные атрибуты. Восстанавливаешь, а Samba не пускает пользователей, потому что ACL ушли. Без -H жёсткие ссылки разворачиваются в отдельные файлы, и каталог с 200 тысячами hardlink внезапно занимает в четыре раза больше. Без —numeric-ids rsync сопоставляет UID/GID по имени, и если на восстанавливаемой системе пользователя с таким именем нет, файлы получают владельца root. Дальше всё через sudo, Samba опять лежит.
Разреженные файлы разворачиваются и съедают диск
Образы дисков ВМ, базы с большими пустыми страницами, файлы подкачки это sparse-файлы. Файловая система показывает «занято 40 ГБ», а физически там 4 ГБ. Копируешь без —sparse или -S, и на бэкапной стороне внезапно оказывается честный гигабайт в гигабайт. Свободное место кончается посреди ночи.
Файлы, открытые процессом, копируются целиком некорректно
Nginx пишет access.log, приложение держит дескриптор на большом конфиге, Transmission докачивает торрент. rsync копирует содержимое на момент открытия дескриптора, не то, что файл сейчас в реальности. Иногда это неважно, иногда получаешь конфиг из середины правки. Для критичных файлов делай снапшот ФС.
Cron без lock запускает параллельный rsync
Копирование каталога с 500 ГБ может занять 3 часа. Cron настроен на каждый час. Второй rsync стартует на целевой каталог, пока первый ещё пишет, и они начинают перекрывать друг другу записи. Итог: файлы смешаны из двух сессий, временные файлы rsync остаются на месте. Лечится flock.
Рецепт: согласованный бэкап и проверка восстановления
Подготовка: что проверить до первого запуска
Сначала определись со сторонами. Источник данных: где живут базы, файлы, образы. Источник места: куда копировать. Отдельный диск, внешний USB, вторая машина по SSH или облако. Диск с бэкапом не должен быть тем же диском, что хранит рабочие данные. Очевидно, но половина домашних серверов настроена именно так.
Проверь свободное место на целевом хранилище. Умножь текущий размер данных на 1.6 для первой копии, дальше инкремент через rsync —link-dest или borg занимает намного меньше.
| Компонент | Минимум | Рекомендую |
|---|---|---|
| ОС хоста | Debian 12, Ubuntu 22.04 LTS | Ubuntu 24.04 LTS, Debian 12 |
| rsync | 3.2.7 и новее | актуальная на момент написания, проверь релизы |
| PostgreSQL | 14 | 16, актуальная на момент написания, проверь релизы |
| MySQL / MariaDB | 8.0 / 10.6 | 8.4 / 11.4, проверь релизы |
| Proxmox VE | 7.4 | 8.x, актуальная на момент написания, проверь релизы |
| Открытое место | 1.6 от объёма данных | 2.5 от объёма (для тестового восстановления) |
Порты нужны только если бэкап идёт на другую машину по SSH или через rsync-демон. Для локального USB-диска сетевые порты не задействованы.
| Порт | Протокол | Назначение | Снаружи |
|---|---|---|---|
| 22 | TCP | SSH/rsync через ssh | Нет, только из LAN или VPN |
| 873 | TCP | rsync-демон, если понадобится | Нет, никогда наружу |
| 5432 | TCP | PostgreSQL (для реплики или pg_dump -h) | Нет, только localhost |
| 3306 | TCP | MySQL/MariaDB | Нет, только localhost |
| 8006 | TCP | Веб-интерфейс Proxmox VE | Нет, только LAN/VPN |
Архитектура потока бэкапа
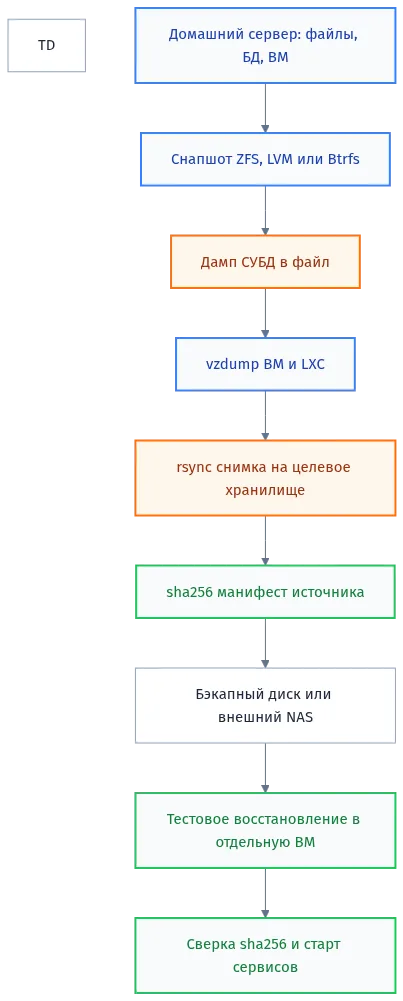
Логика такая. Сначала получаем статический снимок ФС, потом внутри снимка делаем дамп СУБД и образы ВМ, потом копируем снимок на целевое хранилище. Отдельно считаем контрольные суммы. Отдельно раз в месяц разворачиваем бэкап в отдельную ВМ и проверяем, что сервисы поднялись.
Шаг 1. Создай бэкапного пользователя и целевой каталог
Работать под root в бэкапном скрипте удобно, но плохо. Заводишь отдельного пользователя, даёшь ему NOPASSWD только на то, что нужно. Для rsync через sudo вполне хватает. Это защищает от опечатки в пути с —delete, от смонтированного не того диска и от «а, тут же можно и rm -rf запустить».
sudo useradd -r -m -s /bin/bash backuper
sudo mkdir -p /mnt/backup/homesrv
sudo chown backuper:backuper /mnt/backup/homesrv
sudo chmod 750 /mnt/backup/homesrv
id backuper
Ожидаемый результат: пользователь backuper создан, у него есть домашний каталог, целевой каталог ему принадлежит с правами 750.
Шаг 2. Настрой SSH-ключ, если бэкап идёт на удалённую машину
Пароль в cron жить не может, потому что cron не умеет вводить пароль. Ключ, отдельный, без passphrase, ограниченный по команде в authorized_keys, это базовый уровень. Без ограничения любой, кто прочитает ключ, получит шелл на бэкап-сервере.
ssh-keygen -t ed25519 -f ~backuper/.ssh/id_backup -N ""
cat ~backuper/.ssh/id_backup.pub
На бэкап-сервере добавь ключ в ~backuper/.ssh/authorized_keys и ограничь его:
command="rrsync -wo /mnt/backup/homesrv",no-agent-forwarding,no-port-forwarding,no-pty,no-user-rc,no-X11-forwarding ssh-ed25519 AAAA...backup-key
rrsync идёт в комплекте с rsync на большинстве дистрибутивов и жёстко ограничивает каталог, в который можно писать. Ожидаемый результат: ssh -i id_backup backuper@backup-host с командой whoami возвращает отказ, а rsync работает.
Шаг 3. Получи снапшот ФС перед копированием
Без снапшота ты снимаешь живую ФС. Снапшот на ZFS или Btrfs стоит секунды, места не занимает до начала записи, и даёт согласованную точку во времени. На LVM снапшот тяжелее, резервируй место под CoW. Проверь, что ФС вообще умеет снапшоты, иначе придётся останавливать сервисы.
# ZFS
sudo zfs snapshot tank/data@backup-$(date +%Y%m%d-%H%M)
sudo zfs list -t snapshot -o name,used,creation | grep backup-

# Btrfs
sudo btrfs subvolume snapshot -r /mnt/data /mnt/data/.snapshots/backup-$(date +%Y%m%d-%H%M)

# LVM
sudo lvcreate -L 20G -s -n data-snap /dev/vg0/data
Ожидаемый результат: в списке снапшотов появилась запись с текущим временем. Дальше копируешь не живой каталог, а снапшот (для ZFS это /tank/data/.zfs/snapshot/backup-XXX, для Btrfs обычный путь монтирования).
Шаг 4. Сделай дампы баз данных внутри снапшота
Копировать файлы СУБД живым томом нельзя. При этом pg_dump на работающем сервере тоже стоит запускать с флагом —serializable-deferrable или хотя бы в транзакции с -Fc, чтобы дамп был согласован. Иначе половина таблиц попадёт в состоянии до коммита, половина после.
# PostgreSQL, custom format для параллельного восстановления
sudo -u postgres pg_dump -Fc -f /mnt/backup/homesrv/db/pg-$(date +%F).dump mydb

# MySQL/MariaDB с консистентным снапшотом InnoDB
mysqldump --single-transaction --routines --events \
  --all-databases | gzip > /mnt/backup/homesrv/db/mysql-$(date +%F).sql.gz
Ожидаемый результат: файлы дампов созданы, размер не нулевой, первый байт соответствует формату. Проверить можно через pg_restore -l для PostgreSQL и zcat | head -c 200 для MySQL.
Шаг 5. Сделай дампы ВМ и LXC через vzdump
В Proxmox VE не трогай файлы образов руками. vzdump сам выберет режим: snapshot для ZFS, LVM-thin или Ceph, stop для стореджей без снапшотов, suspend при наличии qemu-guest-agent. Режим по умолчанию у vzdump именно snapshot для тех хранилищ, которые его поддерживают.
# Все ВМ и LXC, режим snapshot, zstd, на бэкапный сторедж backup-store
sudo vzdump --all --mode snapshot --compress zstd \
  --storage backup-store --mailnotification failure

# Одна ВМ
sudo vzdump 100 --mode snapshot --compress zstd --storage backup-store
Ожидаемый результат: в /var/lib/vz/dump/ или на указанном сторедже появились файлы .vma.zst с датой и ID. Для LXC без снапшота добавь fsfreeze, тогда дамп приложения будет согласован:
sudo pct fsfreeze 105
sudo vzdump 105 --mode suspend --compress zstd --storage backup-store
sudo pct unfreeze 105
Шаг 6. Скопируй данные через rsync с правильными флагами
Вот здесь чаще всего ломается. Кратко про флаги. -a включает рекурсию и сохранение прав. -H сохраняет жесткие ссылки. -A сохраняет ACL. -X сохраняет xattr. —numeric-ids не пытается сопоставлять UID/GID по именам. —sparse обрабатывает разреженные файлы. Без любого из них восстановление даст сюрприз.
sudo rsync -aHAX --numeric-ids --sparse \
  --delete --delete-excluded \
  --exclude-from=/etc/backup.exclude \
  --partial --info=progress2 \
  /tank/data/.zfs/snapshot/backup-$(date +%Y%m%d)/ \
  /mnt/backup/homesrv/data/
Файл исключений /etc/backup.exclude минимальный:
/proc/
/sys/
/dev/
/run/
/tmp/
/var/cache/
/var/lib/docker/overlay2/
/var/lib/containers/storage/overlay/
*.sock
lost+found
Каталог /var/lib/docker/ целиком копировать нельзя. Overlay2 меняется на живой системе и восстановление контейнеров из этой копии почти всегда идёт через docker system prune и пересборку. Данные контейнеров (volumes, bind-mount) бэкапь отдельно.
Ожидаемый результат: rsync завершился с кодом 0, в логе видно количество переданных байт и файлов. Проверь через rsync —dry-run —itemize-changes ещё раз: вывод должен быть пустым.
Шаг 7. Считай контрольные суммы источника
Без хешей проверить восстановление можно только глазами, а глаза 500 ГБ не проверят. Считай sha256 по дереву файлов, складывай в один манифест, копируй его вместе с данными. Потом на восстановленной копии прогоняешь тот же скрипт и сверяешь два файла через diff. Разница в одну строку уже повод копать.
cd /tank/data/.zfs/snapshot/backup-$(date +%Y%m%d)
find . -type f -print0 | sort -z | \
  xargs -0 -n 1000 sha256sum > /mnt/backup/homesrv/data.sha256
wc -l /mnt/backup/homesrv/data.sha256
Ожидаемый результат: файл манифеста создан, количество строк совпадает с числом файлов в снапшоте. Хранить манифест на том же диске, что и бэкап, бессмысленно, второй экземпляр кладёшь на источник.
Шаг 8. Оберни всё в скрипт с flock и cron
Отдельные команды в cron это дорога к параллельным запускам. Возьми flock, он держит блокировку на файл и не даёт запуститься второй копии. Без него при затянувшемся предыдущем rsync получишь две одновременные записи в целевой каталог.
#!/bin/bash
set -euo pipefail
exec 9>/var/lock/backup.lock
flock -n 9 || { echo "Backup already running"; exit 1; }

DATE=$(date +%Y%m%d-%H%M)
SNAP="tank/data@backup-$DATE"
DEST=/mnt/backup/homesrv

zfs snapshot "$SNAP"
rsync -aHAX --numeric-ids --sparse --delete \
  --exclude-from=/etc/backup.exclude \
  "/tank/data/.zfs/snapshot/backup-$DATE/" "$DEST/data/"

cd "/tank/data/.zfs/snapshot/backup-$DATE"
find . -type f -print0 | sort -z | xargs -0 -n 1000 sha256sum > "$DEST/checksum-$DATE.sha256"

# сохранить только 30 последних снапшотов
zfs list -t snapshot -o name -s creation | grep 'tank/data@backup-' | \
  head -n -30 | xargs -r -n 1 zfs destroy
Ожидаемый результат: скрипт запускается, снапшот создаётся, данные копируются, манифест пишется, старые снапшоты удаляются. Второй запуск во время первого не стартует и логирует отказ.
Шаг 9. Поставь в cron и закрепи порядок
Расписание сделай реалистичное. Полные проходы раз в сутки ночью, снапшоты почаще, полная проверка восстановления раз в месяц. Не ставь ежечасный rsync на 500 ГБ, он никогда не догонит.
0 2 * * * root flock -n /var/lock/backup.lock /usr/local/bin/backup.sh >> /var/log/backup.log 2>&1
0 9 1 * * root /usr/local/bin/verify-restore.sh >> /var/log/restore-verify.log 2>&1
Безопасность на этапе настройки
Несколько вещей, которые отделяют работающий бэкап от проблем.
- Целевой диск не должен быть смонтирован, пока бэкап не пишется. Автоматический mount при старте системы вместе с рабочим диском делает бессмысленным разделение. Монтируй по требованию в скрипте.
- Пользователь backuper не должен иметь право на запись куда угодно. Ограничь rrsync, ограничь права на каталог.
- SSH-ключ только для rsync. Никаких разрешений на port forwarding, agent forwarding, X11. Всё это уже в примере выше.
- Пароли и токены не в скрипте. Если подключаешь облако, используй ~/.config/rclone/rclone.conf с правами 600 и отдельного пользователя.
- UFW на бэкап-сервере: 22 только из LAN и VPN, 873 закрыт совсем. Проверь через sudo ufw status verbose.
- fail2ban на бэкап-сервере для SSH. Без него шум в логах sshd будет нарастать экспоненциально.
Проверка: как убедиться, что бэкап живой
Проверка не в том, что ls показывает файлы. Проверка в том, что восстановление в изолированную среду даёт работающую систему. Разбей это на три уровня: метаданные, содержимое, приложение.
Уровень 1. Целостность манифеста и наличие файлов
Сравни манифест источника с манифестом бэкапа. Считай хеши на восстановленной копии тем же способом и прогони diff. Если разница есть, дальше идти смысла нет, разбирайся с ней.
cd /mnt/backup/homesrv/data
sha256sum -c /mnt/backup/homesrv/checksum-$(date +%F).sha256 2>&1 | grep -v OK$
Ожидаемый результат: пустой вывод или только предупреждения о ненайденных файлах. Любая строка FAILED это битый файл. —quiet показывает только ошибки.
Уровень 2. Тестовое восстановление на отдельный диск
Возьми пустой диск или отдельную ВМ, разверни rsync-копию, проверь, что загрузчик на месте. Файлы файлами, а grub-install и записи в /etc/fstab проверяются только так. Проще всего через rsync на тестовую машину и загрузку в rescue-режиме.
# На тестовой ВМ, после установки чистого Debian и разметки диска
rsync -aHAX --numeric-ids --sparse \
  /mnt/backup/homesrv/data/ \
  /mnt/restore/

# Проверить fstab и загрузчик
less /mnt/restore/etc/fstab
ls /mnt/restore/boot/grub/grub.cfg
ls /mnt/restore/boot/efi/EFI/
Ожидаемый результат: /etc/fstab содержит только существующие устройства (или оставлены комментарии), grub.cfg на месте, каталог EFI заполнен. Если UUID разделов изменились, поправь fstab и перегенерируй grub до загрузки.
Уровень 3. Проверка дампов баз и ВМ
Дампы баз проверяются иначе, чем файлы. PostgreSQL в custom format читается через pg_restore -l без разворота. MySQL дамп это текст, его можно проверить на синтаксис через восстановление в пустую временную схему. ВМ проверяются через qmrestore в отдельный сторедж и пробный запуск.
pg_restore -l /mnt/backup/homesrv/db/pg-$(date +%F).dump | head -20
zcat /mnt/backup/homesrv/db/mysql-$(date +%F).sql.gz | head -50

# Восстановление ВМ под другим ID, чтобы не задеть рабочую
qmrestore /var/lib/vz/dump/vzdump-qemu-100-2024_11_15-02_00_01.vma.zst 900 \
  --storage local-lvm --unique
qm start 900
qm terminal 900
Ожидаемый результат: pg_restore -l выдаёт список объектов, MySQL дамп начинается с корректного SQL, ВМ 900 стартует и логинится. Если не стартует, смотри консоль: чаще всего вопрос в драйверах диска или в BIOS-режиме SeaBIOS vs OVMF.
Уровень 4. Живой smoke-тест после восстановления
Файлы восстановились, сервисы стартуют, но пользователи не работают. Прогони по каждому сервису короткий smoke: Nextcloud отвечает, Samba даёт листинг, PostgreSQL принимает соединение и делает SELECT count(*) FROM pg_class. Это 10 строк на сервис, но вылавливает всё, что не видно в логах.
curl -fsS -o /dev/null -w "%{http_code}\n" http://localhost:8080/status.php
smbclient -L localhost -U%
sudo -u postgres psql -c "SELECT count(*) FROM pg_class;"
systemctl is-active nginx postgresql smbd
Ожидаемый результат: 200 от Nextcloud, листинг Samba без ошибок, число строк из pg_class больше нуля, все сервисы active. Если что-то из этого даёт сбой, бэкап считается непроверенным.
Дальше разбираю осложнения, которые вылазят при восстановлении, альтернативы rsync вроде borg и restic, профилактику с мониторингом и автозапуском, чем отличается полный бэкап от инкрементального и как часто проверять восстановление.
Что ломается после успешного копирования
Файлы скопировались, rsync отчитался нулём, размер совпал. А потом ты разворачиваешь бэкап и получаешь совсем другой сервер. Чтобы не перебирать причины наугад, вот разбор ошибок, которые встречаются чаще всего.
Восстановил, а владельцы файлов поменялись на числовые UID
Ошибка. После восстановления на новую машину файлы принадлежат uid 1000, 33, 1001 вместо нормальных имён. Веб-сервер под nginx не читает свои настройки, MariaDB не стартует, потому что каталог данных теперь чужой.
Причина. Ты копировал rsync без --numeric-ids, а рядом добавил --usermap или запускал от непривилегированного пользователя. Без numeric-ids rsync сопоставляет владельцев по именам: если на новой системе umask или порядок создания пользователей другой, имя nginx может стать uid 998, а исходные uid 33 разъедутся по строкам /etc/passwd.
Решение. Копируй с сохранением числовых id и под root. Логины тогда не важны, важно чтобы номер совпал.
rsync -aHAX --numeric-ids /srv/data/ /backup/srv-data/
После восстановления проверь глазами: ls -ln /srv/data покажет числовые id, ls -l /srv/data покажет имена. Расхождение имён при совпадении номеров значит, что на целевой машине другие пользователи. Создай их до восстановления.
Место ушло в ноль из-за sparse-файлов и жёстких ссылок
Ошибка. На источнике 400 ГБ данных, целевой диск на 500 ГБ забивается до отказа на середине копирования.
Причина. Ты не поставил -S и -H. Разреженные файлы, типичные для образов дисков и дампов VM, разворачиваются в полный размер. Жёсткие ссылки становятся независимыми копиями: k3s, Docker и Steam держат по несколько десятков ссылок на один и тот же объект.
Решение. Добавь оба флага. И заранее посчитай реальный объём на источнике, а не по выводу df.
# Реальный размер с учётом hardlink и sparse
du -sB1 --apparent-size --count-links /srv/data
# Реальный объём на диске
du -sB1 /srv/data

# Копирование с сохранением sparse и hardlink
rsync -aHAXS --numeric-ids /srv/data/ /backup/srv-data/
Разница между apparent-size и фактическим du и есть та экономия, которую ты теряешь без флагов. Если данных уже больше целевого диска, переходи на borg или restic из раздела про альтернативы, там дедупликация даёт больше.
xattr и ACL не выжили
Ошибка. Samba-шара после восстановления отдаёт права по-старому, Podman больше не поднимает контейнеры из-за потерянных user namespace атрибутов, а Nextcloud отказывается писать в свои каталоги.
Причина. Расширенные атрибуты и POSIX ACL не сохранились. Без -X и -A rsync просто не переносит их, а в ext4 они лежат отдельно от обычных прав.
Решение. Убедись, что ФС целевого диска вообще умеет xattr. Тогда копируй с флагами.
# Проверка поддержки на целевой ФС
tune2fs -l /dev/sdb1 | grep -i xattr

# Копирование с атрибутами и ACL
rsync -aHAXSXA --numeric-ids /srv/data/ /backup/srv-data/
Сверь результат: getfacl -R /srv/data > /tmp/src.acl на источнике, то же на цели, и diff. Расхождение будет сразу видно.
База данных восстановилась, но таблицы битые
Ошибка. MySQL или MariaDB после восстановления выдают «Table ‘x’ is marked as crashed and should be repaired» либо InnoDB отказывается стартовать с логом recovery.
Причина. Ты копировал /var/lib/mysql через rsync на работающем сервере. Часть страниц данных попала в кэше InnoDB и не записана на диск, ib_logfile не соответствует ibdata. База несогласованна.
Решение. Есть два пути. Правильный: снимать дамп и отдельно копировать данные через snapshot.
# Дамп всех баз, кроме системных
mysqldump --single-transaction --quick --routines --triggers \
  --events --all-databases | gzip > /backup/mysql/all-$(date +%F).sql.gz
--single-transaction даёт согласованный снимок InnoDB без блокировки таблиц, что важно для работающего сервера. MyISAM таблицы так всё равно остаются горячими, но их в домашнем сервере почти не осталось.
Костыль, если дамп невозможен по времени: останавливаешь БД на пять секунд, копируешь каталог, запускаешь. Не PostgreSQL, где можно применить pg_basebackup или pg_dump, но для маленькой базы хватит.
VM Proxmox после восстановления не грузится
Ошибка. Восстановил qcow2 из бэкапа, VM запускается и уходит в emergency mode. Либо вообще не видит загрузчик.
Причина. Ты копировал файл диска работающей ВМ обычным rsync. ФС внутри VM была в промежуточном состоянии, журнал ФС не закрыт. Плюс при переносе в другую VM конфиг с uuid диска, MAC и машиной поменялись, а fstab остался прежним.
Решение. Никогда не копируй образ живой ВМ rsync-ом. Для Proxmox VE используй vzdump или штатный бэкап через web-интерфейс: Datacenter → Backup → Add.
# Согласованный бэкап одной VM с ZFS-снапшотом
vzdump 101 --storage backup-nfs --mode snapshot --compress zstd

# Список бэкапов хранилища
pvesm list backup-nfs
Режим snapshot работает для ZFS, LVM-thin и Ceph. Для остальных хранилищ vzdump уйдёт в stop и погасит VM на время копирования. Режим suspend даёт согласованность только если внутри установлен qemu-guest-agent.
Если у тебя LXC-контейнер, добавь fsfreeze перед копированием, иначе незакрытые транзакции внутри контейнера приведут к тем же битым логам.
fsfreeze -f /rpool/data/subvol-101-disk-0
pct snapshot 101 pre-backup
fsfreeze -u /rpool/data/subvol-101-disk-0
pct listsnapshot 101
Cron насобирал параллельных копий
Ошибка. В целевом каталоге половина файлов из позавчерашнего состояния, половина из вчерашнего. rsync в этот раз завершился с кодом 12 или 23.
Причина. Задача в cron запустилась поверх предыдущей, потому что предыдущая длилась больше интервала. Два rsync пишут в один каталог, каждый видит чужой временный dot-file и делает из него живой.
Решение. Всегда оборачивай в flock. Не жди, а пропускай, если уже идёт.
flock -n /var/lock/backup.lock rsync -aHAXSXA --numeric-ids \
  --delete-after /srv/data/ /backup/srv-data/
-n означает «не ждать, если лок занят». Для бэкапа это правильнее ожидания: следующий запуск стартанёт по своему расписанию, а не в конце предыдущего.
Файл, открытый процессом, скопировался в промежуточном состоянии
Ошибка. База транзакций или лог приложения после восстановления пуст, хотя на источнике в нём тонна записей.
Причина. Процесс писал в файл ровно тогда, когда rsync его читал. Никакой поток данных в такой ситуации не восстанавливается целиком.
Решение. Снапшот ФС до копирования. Это единственный надёжный способ, и он есть в ZFS, Btrfs, LVM, а также в dattobd для ext4.
# ZFS: снапшот, монтирование, копирование, размонтирование, удаление
zfs snapshot rpool/data@bk-$(date +%F)
mount -t zfs rpool/data@bk-$(date +%F) /mnt/snap
rsync -aHAXSXA --numeric-ids /mnt/snap/ /backup/srv-data/
umount /mnt/snap
zfs destroy rpool/data@bk-$(date +%F)
Для Btrfs то же самое, только btrfs subvolume snapshot -r. Снапшот живёт секунды, файлы в нём заморожены на момент снятия, и никакая запись в живой ФС копирование не портит.
Чем ещё можно делать бэкап домашнего сервера
rsync хорош, но у него есть два недостатка для больших домашних хранилищ: он не дедуплицирует и не умеет в шифрование. Если объём данных растёт или выносишь бэкап за пределы домашней сети, смотри в сторону специализированных инструментов.
Borg
Дедуплицирует блоками, сжимает, шифрует, умеет инкрементальные архивы с проверкой целостности. Один репозиторий, куча снапшотов, каждое последующее состояние экономит десятки процентов.
borg init --encryption=repokey-blake2 /backup/borg-repo
borg create --stats --compression zstd,10 \
  /backup/borg-repo::srv-$(date +%F) /srv/data
borg check --verify-data /backup/borg-repo
--verify-data перечитывает все блоки и сверяет их хеши. Долгая операция, но её стоит гонять хотя бы раз в месяц. Особенность Borg в том, что репозиторий залочен: параллельные записи ломают индекс, поэтому ставь те же flock.
restic
По возможностям близок к Borg, но пишет в обычные S3, B2, SFTP и локальные каталоги. Никакой серверной части, только бинарь. Восстановление отдельного файла делается за секунды.
export RESTIC_REPOSITORY=s3:https://s3.example.com/backup
export RESTIC_PASSWORD_FILE=/etc/restic.password
restic init
restic backup /srv/data --tag srv
restic check --read-data-subset=10%
restic restore latest --target /tmp/restore-test
--read-data-subset=10% вычитывает и проверяет десятую часть блоков каждый прогон. За месяц накопится полная проверка без ежемесячных многочасовых остановок.
snapshot-семейство: ZFS auto-snapshots, sanoid, btrbk
Если у тебя ZFS или Btrfs, снапшоты это лучший первый слой. Sanoid делает ротацию по расписанию, btrbk умеет отправлять снапшоты на удалённую систему через zfs send и receive.
# zfs send удалённо
zfs snapshot rpool/data@bk-$(date +%F)
zfs send -i rpool/data@bk-prev rpool/data@bk-$(date +%F) \
  | ssh backup@remote zfs receive backup/data

# btrbk для Btrfs
btrbk run --preserve
Отдача в том, что весь 3-2-1 выполняется одной командой. Риск: send без -w не сохраняет xattr и ACL, а без верификации ты не узнаешь, что удалённая копия читаема. Делай периодическое zfs list -t snapshot и zdb -U на приёмнике.
Duplicity и его обёртка duply
Старый, но живой вариант для тех, кому нужен шифрованный инкрементальный архив прямо в облако. Работает через librsync и GPG. Минус в том, что полное восстановление идёт медленнее borg из-за формата архива.
duplicity --full-if-older-than 30D \
  --encrypt-key YOURKEY /srv/data sftp://backup@nas/srv
duplicity verify --compare-data sftp://backup@nas/srv /srv/data
Выбор прост: маленький домашний сервер и 3-4 ТБ данных → rsync с флагами и снапшотами. Больше 10 ТБ или облачная выгрузка → borg или restic. ZFS-пул без облака → sanoid плюс zfs send.
Профилактика: чтобы не разбираться с этим в следующий раз
Пара часов, вложенных сейчас, экономит сутки восстановления потом. Меньше всего приятного в том, что «в следующий раз» наступает ровно тогда, когда ты не готов.
Что копировать: чек-лист
Не надо копировать систему целиком. Составь список и проверяй его при первом запуске каждого сервиса.
| Что | Где лежит обычно | Особенности |
|---|---|---|
| Данные пользователей | /home, /srv | Нужны -HAX и numeric-ids |
| Конфиги приложений | /etc, /opt/app/conf | Обычно маленькие, ходить часто |
| Дампы БД | Скрипт в /usr/local/bin, результат в /backup/mysql | Не файлы каталога данных |
| ВМ и контейнеры | vzdump-архивы | Только snapshot-режим |
| Метаданные ZFS или Btrfs | zfs list, btrfs subvolume list | Сохрани вывод в файл |
| Конфиг сети | /etc/network, netplan, nftables.conf | Понадобится при bare-metal восстановлении |
| Список пакетов | dpkg —get-selections | Без него долго поднимать идентичный сервер |
| Пользователи и группы | /etc/passwd, /etc/group, /etc/shadow | Копируй, но понимай риски |
Сохрани список установленных пакетов при каждом запуске бэкапа. Плюс отдельно зафиксируй, где корневой диск, какая разметка, какой загрузчик стоит.
dpkg --get-selections > /backup/meta/packages-$(hostname)-$(date +%F).txt
lsblk -o NAME,SIZE,FSTYPE,UUID,MOUNTPOINT > /backup/meta/lsblk-$(hostname).txt
blkid > /backup/meta/blkid-$(hostname).txt
efibootmgr -v > /backup/meta/efibootmgr.txt
cat /proc/mdstat > /backup/meta/mdstat.txt
Эти четыре файла займут килобайты, а сэкономят часы при пересборке системы на новом железе.
Как часто: расписание под реальность
Домашний сервер обычно не банк, но и не файлопомойка. Ориентируйся на скорость изменения данных, а не на паранойю.
| Слой | Частота | Где хранить |
|---|---|---|
| Снапшоты ZFS или Btrfs | Каждые 15-60 минут | На том же пуле |
| Дампы баз | Раз в сутки, ночью | Отдельный диск плюс удалённо |
| rsync или borg на внешний диск | Раз в сутки | USB-диск, отключаемый после копирования |
| ВМ и контейнеры | Раз в сутки или раз в неделю | Отдельное хранилище, не на том же пуле |
| Полная синхронизация в облако | Раз в неделю | Backblaze B2, S3, Hetzner Storage Box |
| Тест восстановления | Раз в месяц | Одноразовая VM или отдельный диск |
Правило 3-2-1 никто не отменял: три копии, два носителя, одна за пределами дома. Внешний USB-диск, который после копирования отключаешь физически, закрывает второй носитель и одновременно слой защиты от шифровальщика.
Автозапуск и логирование
Юнит systemd предпочтительнее cron, потому что даёт статус, таймер, ограничения по ресурсам и нормальный лог без пляски с бубном вокруг почтовых уведомлений.
# /etc/systemd/system/backup.service
[Unit]
Description=Nightly backup of /srv/data
After=network-online.target
Wants=network-online.target

[Service]
Type=oneshot
User=root
ExecStart=/usr/local/bin/backup.sh
IOSchedulingClass=idle
CPUWeight=50
Nice=19
# /etc/systemd/system/backup.timer
[Unit]
Description=Run nightly backup

[Timer]
OnCalendar=daily
Persistent=true
RandomizedDelaySec=30m

[Install]
WantedBy=timers.target
Persistent=true догоняет пропущенный запуск, если сервер был выключен. RandomizedDelaySec разносит запуск по времени, чтобы не бить по диску ровно в полночь каждой ночью.
systemctl daemon-reload
systemctl enable --now backup.timer
systemctl list-timers backup.timer
journalctl -u backup.service -n 50 --no-pager
Скрипт должен завершаться с ненулевым кодом при любой ошибке. Тогда systemctl status backup.service сразу покажет красный failed, и это увидит любой мониторинг.
Мониторинг: как узнать о поломке раньше, чем понадобится восстановление
Логи читать никто не будет. Нужен активный сигнал. Минимум, который работает: heartbeat-файл с датой последнего успеха плюс проверка свободного места.
# В конце скрипта бэкапа
date +%s > /var/lib/backup/heartbeat
curl -fsS -m 10 "https://hc-ping.com/UUID" || \
  echo "ping failed" | mail -s "backup ping failed" admin@example.com
Если heartbeat старше 36 часов, что-то сломалось. Эта проверка ловит и забитый диск, и отвалившийся USB, и подвисший rsync.
Добавь проверку SMART на диске с бэкапом. Умирающий диск с копией не менее опасен, чем умирающий диск с данными.
smartctl -a /dev/sdb | grep -E "Reallocated|Pending|Uncorrectable"
zpool status -x tank
btrfs device stats /mnt/srv
Для Zabbix или Uptime Kuma заведи отдельный item: время с момента изменения heartbeat. Порог 36 часов, важность critical. Ещё один item по размеру последней копии: если он упал вдвое по сравнению со средним, что-то отвалилось на источнике.
Безопасность: чужие руки возле бэкапа хуже, чем отсутствие бэкапа
Отдельный пользователь для бэкапа. Не root, не твоя учётка. Только чтение источника и запись в целевой каталог.
useradd -m -s /bin/bash bkp
mkdir -p /backup/srv-data
chown bkp:bkp /backup/srv-data
chmod 0700 /backup/srv-data

# SSH-ключ только для rsync, без shell
# В authorized_keys на приёмнике:
# command="rsync --server --sender -e.LsfxC . /srv/data/",no-pty,no-agent-forwarding ssh-ed25519 AAAA...
Такая строка в authorized_keys разрешает пользователю только rsync-приём и ничего больше. Ни ssh, ни scp, ни port forwarding. Если ключ украдут, атакующий сможет только читать /srv/data.
Если бэкап уходит наружу, шифруй до отправки. Borg с repokey, restic с паролем, duplicity с GPG. Клиентское шифрование обязательно, потому что провайдер хранилища видит только зашифрованные блоки и ничего не сможет с ними сделать при утечке аккаунта.
Права на пароль к репозиторию: chmod 600, владелец root, файл вне каталога с бэкапом. Не в git, не в Nextcloud, не в почте. Если кто-то получит и пароль, и доступ к репозиторию, шифрование бесполезно.
install -m 0600 -o root -g root /dev/null /etc/restic.password
chattr +i /etc/restic.password
chattr +i делает файл неизменяемым даже для root, пока не снимешь атрибут явно. Мелочь, но защищает от случайного удаления при массовой чистке.
Обновление без слёз и откат
Перед любым обновлением на сервере бэкапа: сначала снимаешь снапшот корня и сохраняешь список пакетов, только потом ставишь обновления.
zfs snapshot rpool/ROOT/ubuntu@before-upgrade
apt update
apt list --upgradable > /var/log/upgrade-candidates-$(date +%F).txt
apt -y upgrade
Если обновление ломает rsync или borg, откат делается мгновенно на ZFS.
zfs list -t snapshot rpool/ROOT/ubuntu
# в скобках зафиксируй имя снапшота, потом при необходимости:
zfs rollback rpool/ROOT/ubuntu@before-upgrade
Для дистрибутивов без снапшотов корня ставь unattended-upgrades только на security-ветку, а крупные обновления ядра ставь руками. И перезагружайся до того, как ставить следующие, иначе однажды поймаешь незагружающееся ядро с единственной рабочей конфигурацией в загрузчике.
Тест восстановления: то, без чего бэкап не бэкап
Раз в месяц разворачивай что-нибудь из копии. Не папку целиком, но обязательно что-то с реальным содержимым: файл, базу, одну VM. Сверяй sha256.
# Контрольные суммы на источнике
find /srv/data -type f -print0 | xargs -0 sha256sum > /backup/meta/src-sum.txt

# После восстановления
find /tmp/restore-test -type f -print0 | xargs -0 sha256sum > /tmp/restore-sum.txt
diff <(sort /backup/meta/src-sum.txt) <(sort /tmp/restore-sum.txt)
Совпадающие хеши говорят о содержимом. Расхождение в правах и owner всё равно надо проверять отдельно через stat.
stat -c "%n %a %U:%G" /srv/data/some/file
getfacl /srv/data/some/dir
getfattr -d -m - /srv/data/some/file
Плюс раз в полгода делай полный DR-прогон: поднимаешь VM на новом гипервизоре, восстанавливаешь данные, доводишь сервис до состояния "принимает клиентов". Это ловит отсутствующие загрузчики, забытые записи в fstab и прочие вещи, которые на обычных файлах не видны. Единственное, чего я не видел ни у одного домашнего хостера, это fsfreeze на работающей ВМ перед ручным копированием. Все повторяют одни и те же грабли.
FAQ: "люди также спрашивают"
Почему резервное копирование домашнего сервера не работает после настройки?
В девяти случаях из десяти виновата одна из четырёх вещей: cron без flock запускает параллельные копии, целевой диск заполнен, SSH-ключ потерял права из-за смены UID, либо ФС источника не даёт снапшоты и копирование ловит файлы в промежуточном состоянии. Проверь статус юнита или cron-задания, потом свободное место и логи rsync или borg за последние сутки. Ошибки с кодом 23 в rsync означают ошибку ввода-вывода на цели, код 12 означает ошибку протокола.
Как проверить, что бэкап восстанавливается правильно?
Разверни копию на отдельном диске или отдельной VM, не поверх рабочей системы. Сверь sha256 файлов на источнике и на восстановленной копии. Проверь права, owner, xattr через stat и getfacl. Если бэкап включает базу, подними её на тестовом инстансе и прогони mysqldump или pg_dump обратно, чтобы убедиться, что данные читаются. Если бэкап включает ВМ, запусти копию на другом хосте и убедись, что гость успешно загрузился.
Чем сделать бэкап виртуальных машин Proxmox?
Только штатным vzdump или через web-интерфейс Datacenter → Backup → Add. Для ZFS, LVM-thin и Ceph используй режим snapshot, он не гасит VM и даёт согласованное состояние. Для остальных хранилищ vzdump уйдёт в режим stop, и это нормально: лучше погасить VM на минуту, чем получить несогласованную ФС. Копирование файла диска работающей VM через rsync категорически не годится.
Почему rsync меняет владельцев файлов?
Без флага --numeric-ids rsync сопоставляет владельцев по именам, а не по числовым UID. Если на целевой системе nginx имеет uid 998, а на источнике 33, файлы после копирования будут выглядеть как принадлежащие другому пользователю. Добавь --numeric-ids в команду и следи, чтобы имена пользователей на обеих системах совпадали по UID до начала копирования.
Как бэкапить базу данных на работающем сервере?
Никогда не копируй каталог данных СУБД через rsync на работающем сервере, файлы будут неконсистентны. Используй логический дамп с флагом согласованности: для MySQL и MariaDB mysqldump --single-transaction, для PostgreSQL pg_dump или pg_basebackup. Для очень больших баз делай снапшот ФС через ZFS или LVM, копируй его целиком и уже на снапшоте работай без риска.
Как проверить целостность резервной копии?
Для rsync-бэкапа сверяй sha256 каждой копии с записанным хешем источника. Для borg запусти borg check --verify-data, для restic restic check --read-data-subset=10%. Для ZFS сделай zpool scrub на пуле с бэкапом, это выявит повреждения на уровне блоков. Для дампов баз проверяй gzip на битость через gzip -t и раз в квартал разворачивай дамп на тестовой инстанс.
Что копировать в бэкапе домашнего сервера обязательно?
Данные пользователей из /home и /srv, конфигурация из /etc, согласованные дампы всех баз, архивы VM и LXC через vzdump, список установленных пакетов и разметки дисков. Отдельно сохрани /etc/passwd, /etc/group и /etc/shadow, чтобы после восстановления создать пользователей с теми же UID. Не забудь список пакетов dpkg и вывод lsblk, это экономит часы при пересборке сервера на новом железе.
Чем rsync отличается от borg и restic?
rsync делает точную копию файлов без сжатия и дедупликации. Хорош для маленьких, часто меняющихся наборов и для синхронизации между двумя хостами. Borg и restic делают инкрементальные архивы с дедупликацией по блокам, сжатием и шифрованием: место экономится в разы, но восстановление отдельного файла требует разбора индексов репозитория. Выбор прост: для 3-4 ТБ домашних данных и локального диска rsync с флагами закрывает задачу. Для 10 ТБ и выгрузки в облако имеет смысл borg или restic.
Прогноз
Если ты дошёл до сюда и настроил всё, у тебя на сервере теперь три уровня защиты. Снапшоты ФС на 15-60 минут, ночной rsync или borg на внешний диск, недельная выгрузка в удалённое хранилище. Плюс скрипт с flock, юнит systemd с Persistent=true и heartbeat, который увидит отвалившийся диск за 36 часов, а не через полгода.
Самый недооценённый пункт из всего этого не в командах копирования, а в ежемесячном тесте восстановления. Тот, кто его делает, узнаёт о проблемах до аварии. Кто не делает, узнаёт о них ровно в момент, когда деньги, работа или чужая свадебная съёмка зависят от одной папки, которой "вроде бы точно была копия".
Если что-то в твоём сценарии не сработало, особенно странные ошибки rsync или зависшие vzdump-задачи, кидай сюда лог. Разберёмся, у меня на такие случаи терпения хватит.
Ну и напоследок: синхронизировать директорию с бэкапом, а потом её же удалить с источника это не бэкап, а перенос. Проверяй, что копия лежит отдельно от данных. Тогда твои 4 ТБ семейных фотографий переживут и отказавший SSD, и неудачный rm -rf, и кривой рецепт с форума, на который ты клюнул в третьем часу ночи.

Author: Поп Растрига
Оставайтесь на связи
Рецепты от IT-боли. Без воды, без рекламы, без маркетинговой шелухи.
Подписаться на IT-Аптеку →


У меня домашний сервер на OpenMediaVault, и Proxmox там не при чём. Виртуалки крутятся в VirtualBox, диск с образами лежит в отдельном каталоге. Внутри гостя Windows, в ней MS SQL Express. Если я перед копированием просто гашу виртуалку целиком, как в статье про режим stop, получается долго и клиенты ругаются. А если не гашу, файлы .vdi уезжают с открытым журналом, и SQL потом ругается на повреждение базы. Пробовал vzdump, но он только для Proxmox. Подскажи, как быть с VirtualBox и гостевой виндой на другом гипервизоре, есть ли для неё аналог snapshot-режима, или придётся каждый раз гасить машину перед бэкапом?
Для VirtualBox аналог vzdump есть, это VBoxManage. Два рабочих способа. Первый: VBoxManage snapshot vmname take backup-YYYYMMDD —live, если гость на Linux с установленным VBoxGuestAdditions и запущен, снапшот снимается в согласованном виде. Второй, для Windows без гостёвых дополнений, VBoxManage controlvm vmname savestate, машина уходит в паузу с сохранением состояния ОЗУ на диск, файлы .vdi больше не пишутся, дальше спокойно копируешь каталог Machines, потом controlvm resume. Состояние ОЗУ скидывается в отдельный файл рядом, его тоже забирай. Что важно: MS SQL Express спит по расписанию, поэтому внутри гостя перед savestate прогоняй sqlcmd с BACKUP DATABASE на диск, а не полагайся на консистентность .vdi. Проверить, что savestate действительно произошёл, можно через VBoxManage showvminfo vmname | grep State, там будет Saved вместо Running. Если VM живёт на raw-диске, а не на .vdi, способ не сработает, только гаснуть. И каталог Snapshot в Machines забирай тоже, иначе после восстановления ветка отката не найдётся.
Совсем застрял на ldap_dump: почему одного -Fc мало для консистентности? Если pg_dump читает таблицы в одной транзакции, откуда берётся разрыв, когда кто-то пишет в мастер во время дампа? Думал, как договор на подпись: пока документ подписывают, новые правки уже летят. Что именно ломает целостность и как проверяешь, что дамп снят согласованно?
Согласованность даёт не -Fc, а сама транзакция pg_dump с уровнем REPEATABLE READ или SERIALIZABLE. Если запускаешь pg_dump без опций, он работает в REPEATABLE READ по умолчанию для обычного режима и видит один и тот же снапшот данных. -Fc включает формат custom и позволяет сжимать и параллелить, но не управляет уровнем изоляции. Для жёсткого контроля используй —serializable-deferrable: он ждёт точку, где транзакция может стартовать без конфликтов, но это добавляет задержку и не работает с параллельным COPY. Проверить результат можно так. Сразу после дампа запусти pg_restore -l dumpname | grep -c «TABLE DATA» и сравни с числом таблиц в исходной базе: SELECT count(*) FROM pg_class WHERE relkind = ‘r’. Если числа расходятся, значит часть таблиц не попала в дамп. Для проверки целостности содержимого восстанавливай дамп в отдельную базу и прогоняй pg_checksums или сравнивай контрольные суммы по ключевым таблицам через SELECT md5(array_agg(t.*)::text) FROM table t. Ещё нюанс: pg_dump не блокирует таблицы на запись, если не указан —lock-wait-timeout. В момент старта он берёт ACCESS SHARE, и параллельный DDL вроде ALTER TABLE может привести к ошибке дампа. Для критичных баз лучше сначала снять снапшот ФС, а уже внутри него запускать pg_dump. Так ты фиксируешь точку во времени на уровне файловой системы и не зависишь от поведения транзакций PostgreSQL.