

1. Проверь повторным прогоном без изменений кода: разошедшийся результат это плавающий тест.
2. Ищи общее состояние: одна тестовая база на всех, файлы в общем каталоге, глобальные переменные.
3. Убирай фиксированные задержки и приводи время к фиксированному часовому поясу.
4. Внешние сервисы закрывай моками или подменой окружения.
5. Тест, который проверяет только код ответа, регрессию в теле и побочных эффектах не поймает.
Поднял прогон. Зелёный на ноутбуке, красный на CI. Знакомо?
Если у тебя локально всё зелёное, а на сервере сборки тесты падают через раз, это не мистика и не «плохой раннер». На одинаковом коде результат разный. Такое поведение называется плавающими тестами, или flaky tests, и разбирается оно методично, а не перезапуском.
Причин, почему падают тесты, конечное число. Все они сводятся к одному: тест зависит от чего-то, чем ты не управляешь. Дата, часовой пояс, порядок запуска, сеть, скорость раннера, состояние базы, права процесса. Как только зависимость зафиксирована или изолирована, тест становится предсказуемым.
Дальше разберу, что именно ломает прогон, и дам порядок настройки, после которого повторный запуск даёт тот же результат. Времени на первичную настройку уйдёт от полутора часов, если проект небольшой. Нужны доступ к репозиторию, к серверу сборки и к конфигу тестового окружения.
Что будет по шагам: карта причин, подготовка окружения, изоляция базы, фиксация времени и часового пояса, подмена внешних сервисов, детерминированный порядок тестов, проверка стабильности повторными прогонами. Каждый шаг с командой и с тем, что должно получиться на выходе.
Почему тесты падают: причины, которые ловятся на любом стеке
Общее изменяемое состояние между тестами
Классика. Тест A создал запись, тест B рассчитывает на пустую таблицу и находит чужую запись. Локально ты запускал только B, всё было зелёным. На CI запустился весь набор по алфавиту, и порядок поменялся. Результат зависит от порядка запуска, и это уже не тесты, а лотерея.
Симптом простой: тест проходит в одиночку и падает в полном прогоне. Лечится изоляцией состояния, не перестановкой тестов.
Зависимость от даты, времени и часового пояса
Тест, который проверяет «запись старше 30 дней удаляется», сломается 31 числа. Тест, который сравнивает локальное время с UTC, сломается при смене TZ на раннере. Около полуночи такие тесты падают с особой охотой. Раннер в UTC, разработчик в UTC+3, разница уже есть.
Фиксированные задержки вместо ожидания условия
sleep(2) работает, пока раннер свободен. Под нагрузкой операция не успевает за две секунды, тест падает. На быстром железе тот же sleep избыточен и тест идёт дольше, чем нужно. Задержка это не синхронизация, а надежда.
Тест проверяет только код ответа
Отдал 200, тест зелёный. А в теле ответа поменялось поле, а запись в базу не легла, а побочный эффект не сработал. Код ответа покрывает транспорт, логику он не проверяет. Регрессия проезжает мимо.
Внешние сервисы по сети
Тест дёргает платежный шлюз или чужой API. Сервис недоступен, тест упал. Или сервис отвечает по-другому, потому что это внешний контур, и ты на него не влияешь. Прогон становится зависимым от чужого аптайма.
Тестовая БД без изоляции от рабочей
Одна строка в конфиге подключения указывает не на ту базу. Тест на очистку данных отрабатывает по продакшену. Это уже не про зелёный прогон, а про потерянные данные. Такая ошибка встречается чаще, чем хочется думать.
Запуск от root и с избыточными правами
От root всё работает. В продакшене процесс идёт от отдельного пользователя и спотыкается о права на файл, на сокет, на каталог. Тест маскирует ошибку прав, которую потом ловит эксплуатация.
Несопоставимые условия для тестов производительности
Бенчмарк без фиксированных ресурсов, без числа параллельных воркеров, без ограничения CPU даёт разные цифры на каждом запуске. Сравнивать такие результаты между собой нельзя.
Кодировка и не-ASCII символы
Строки с кириллицей ломаются, если одно место пишет в UTF-8, а другое читает в локальной кодировке. Тест на ASCII пройдёт, тест на русском тексте упадёт.
Плавающие тесты как отдельная категория
Всё перечисленное вместе даёт flaky: на одном коде прогон то зелёный, то красный. Выявляется повторным запуском без изменений. Пока flaky не изолирован, зелёный цвет прогона ничего не гарантирует.
Рецепт: подготовка окружения
Что нужно до начала
Доступ на запись в репозиторий. Отдельная тестовая база, не связанная с рабочей ни строкой в конфиге. Сервер сборки с известным числом воркеров. Пользователь для запуска тестов, который не root.
Проверь среду до того, как что-то менять. Три команды покажут версии рантайма, наличие изоляции и текущее время.
python3 --version
node --version
env | grep -Ei 'TZ|LANG|LC_ALL|DATABASE_URL|DB_HOST'
date -u
Ожидаемый результат: версии, которые поддерживает проект, и явный тестовый DSN в переменной подключения. Если в DATABASE_URL видишь боевой хост, останавливайся и правь конфиг. Дальше идти нельзя.
Системные требования
| Компонент | Версия | Примечание |
|---|---|---|
| ОС | Ubuntu 22.04 или 24.04 LTS | актуальная на момент написания, проверь релизы |
| Python | 3.11 или новее | актуальная на момент написания, проверь релизы |
| Node.js | 20 LTS или новее | актуальная на момент написания, проверь релизы |
| PostgreSQL | 15 или новее | для тестовой базы поднимается отдельный инстанс |
| pytest | актуальная на момент написания, проверь релизы | для проектов на Python |
| Docker Engine | актуальная на момент написания, проверь релизы | если база и моки идут в контейнерах |
На момент публикации актуальна версия PostgreSQL 15 и Node.js 20 LTS. Перед установкой проверь свежие релизы.
Таблица портов
| Порт | Протокол | Назначение | Доступен снаружи |
|---|---|---|---|
| 5432 | TCP | тестовая PostgreSQL | нет, только localhost |
| 8080 | TCP | мок внешнего API | нет, только localhost |
| 6379 | TCP | Redis для фикстур | нет, только localhost |
| 22 | TCP | SSH на раннер | только с доверенных IP |
Схема взаимодействия компонентов
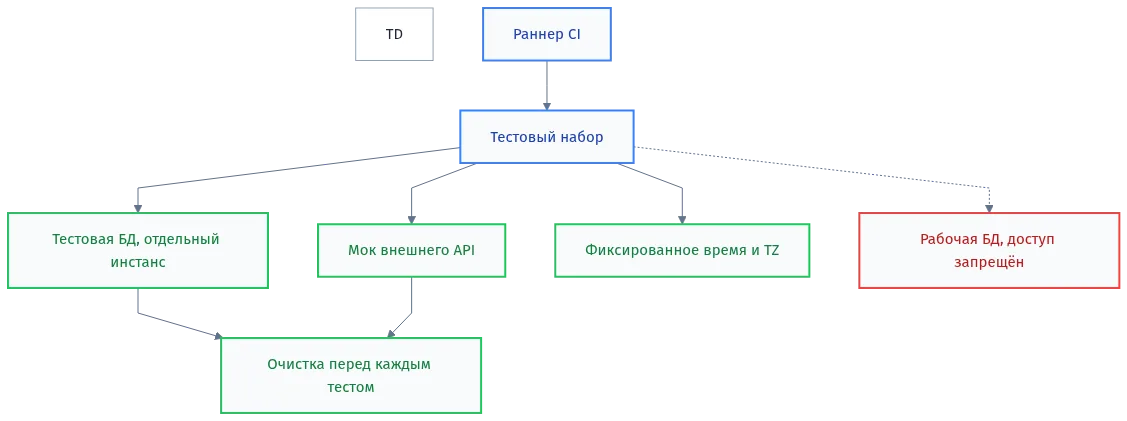
Шаг 1. Заводим отдельную тестовую базу
Зачем: пока тесты ходят в ту же базу, что и приложение, любая ошибка в конфиге портит данные. Развяжи их на уровне инстанса, а не имени схемы.
sudo -u postgres psql -c "CREATE USER app_test WITH PASSWORD 'change_me';"
sudo -u postgres psql -c "CREATE DATABASE app_test OWNER app_test;"
sudo -u postgres psql -c "REVOKE ALL ON DATABASE app_test FROM PUBLIC;"
Ожидаемый результат: пользователь app_test и база app_test. Доступа к рабочей базе у этого пользователя нет и быть не должно.
Шаг 2. Фиксируем строку подключения в тестовом окружении
Зачем: конфиг должен брать DSN из переменной окружения, а не из общего файла, который правится руками.
# .env.test
DATABASE_URL=postgresql://app_test:change_me@127.0.0.1:5432/app_test
TZ=UTC
LANG=C.UTF-8
LC_ALL=C.UTF-8
Ожидаемый результат: при запуске тестов переменные подхватываются из .env.test, а не из .env приложения. Проверь, что файл в .gitignore и пароль не уехал в репозиторий.
Шаг 3. Изолируем данные между тестами
Зачем: тесты не должны видеть записи друг друга. Самый предсказуемый способ на реляционной базе это оборачивать каждый тест в транзакцию и откатывать её.
import pytest
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker
import os

ENGINE = create_engine(os.environ["DATABASE_URL"])
Session = sessionmaker(bind=ENGINE)

@pytest.fixture
def db_session():
    connection = ENGINE.connect()
    transaction = connection.begin()
    session = Session(bind=connection)
    try:
        yield session
    finally:
        session.close()
        transaction.rollback()
        connection.close()
Ожидаемый результат: после каждого теста база в исходном состоянии. Очистка не нужна. Если используешь truncate вместо транзакции, не забудь чистить и последовательности.
Шаг 4. Фиксируем время и часовой пояс
Зачем: тест не должен зависеть от текущей даты и таймзоны раннера.
import pytest
from freezegun import freeze_time

@pytest.fixture(autouse=True)
def frozen_now():
    with freeze_time("2024-06-01 12:00:00"):
        yield
Ожидаемый результат: внутри теста datetime.now() всегда возвращает одно значение. Для языков без freezegun подменяй часы через абстракцию времени, а не через прямой вызов системных функций.
Шаг 5. Убираем sleep и ждём условие
Зачем: фиксированная задержка нестабильна на загруженном раннере. Жди наступления события с таймаутом.
from tenacity import retry, stop_after_delay, wait_fixed

@retry(stop=stop_after_delay(5), wait=wait_fixed(0.1))
def wait_for_status(client, job_id, expected):
    assert client.get_status(job_id) == expected
Ожидаемый результат: тест ждёт до пяти секунд и выходит сразу, как условие выполнено. Разброс времени прогона падает, ложных падений нет.
Шаг 6. Закрываем внешние сервисы моком
Зачем: прогон не должен зависеть от чужого аптайма. Поднимай локальный мок и указывай на него адресом через переменную окружения.
python3 -m http.server 8080 --directory ./tests/mocks &
export PAYMENT_API_URL=http://127.0.0.1:8080
Ожидаемый результат: тесты бьют в локальный мок. Если сеть на раннере отключена полностью, прогон всё равно зелёный.
Шаг 7. Делаем порядок тестов детерминированным
Зачем: зависимость от порядка запуска это скрытая связь между тестами. Включай случайный порядок, чтобы связи вылезали явно, а не тонули в стабильном алфавитном прогоне.
pytest --random-order-seed=42
pytest -p no:randomly
Ожидаемый результат: первый запуск с фиксированным сидом воспроизводим, второй запуск без перемешивания это обычный прогон. Если тест зелёный только при одном сиде, у тебя общее состояние.
Шаг 8. Проверяем не только код ответа
Зачем: 200 не значит, что логика отработала.
def test_create_user(client, db_session):
    resp = client.post("/users", json={"name": "Тест"})
    assert resp.status_code == 201
    body = resp.json()
    assert body["name"] == "Тест"
    row = db_session.query(User).filter_by(id=body["id"]).one()
    assert row.name == "Тест"
Ожидаемый результат: проверены статус, тело ответа и запись в базе. Регрессия в логике ловится, а не проезжает мимо.
Шаг 9. Запускаем тесты не от root
Зачем: избыточные права маскируют ошибки доступа, которые вылезут в продакшене.
sudo useradd -r -s /usr/sbin/nologin testrunner
sudo chown -R testrunner:testrunner /srv/app
sudo -u testrunner pytest -q
Ожидаемый результат: прогон идёт от testrunner. Всё, что требует root, должно всплыть сейчас, а не на выкатке.
Безопасность на этапе настройки
Пароль тестовой базы не храни в репозитории, только в .env.test вне гита. Убедись, что пользователь app_test не имеет прав на рабочую базу: проверь через psql -c «\l» и посмотри владельца. Ограничь доступ к тестовой базе и моку по localhost через ufw. SSH на раннер держи только с доверенных адресов. Если раннер общий, изолируй прогон в контейнере, чтобы тесты не трогали файлы соседних задач.
sudo ufw allow from 127.0.0.1 to any port 5432 proto tcp
sudo ufw deny 5432
sudo ufw status verbose
Ожидаемый результат: порт 5432 доступен только с localhost. Снаружи соединение отбивается.
Проверка: тест стабилен или всё ещё плавает
Прогони набор пять раз подряд без изменений в коде. Если результат разный, тест плавает, и причина ещё не устранена.
for i in 1 2 3 4 5; do
  pytest -q --random-order-seed=$i 2>&1 | tail -n 3
done
Ожидаемый результат: пять одинаковых строк с количеством пройденных и упавших тестов. Сиды разные, итог один.
Проверь, что база изолирована. Останови тестовую базу и убедись, что тесты падают с ошибкой подключения, а приложение при этом работает.
sudo systemctl stop postgresql
pytest -q -x
sudo systemctl start postgresql
Ожидаемый результат: остановка тестовой базы роняет только прогон. Рабочее приложение не затронуто.
Проверь фиксацию времени. Запусти тест с фиктивным TZ, результат должен быть тем же.
TZ=America/New_York pytest -q tests/test_expiry.py
TZ=UTC pytest -q tests/test_expiry.py
Ожидаемый результат: обе команды зелёные. Если результат разный, где-то остался вызов системного времени в обход фикстуры.
Проверь, что внешние сервисы действительно подменены. Отключи сеть на раннере и запусти тесты.
sudo ip link set eth0 down
pytest -q
sudo ip link set eth0 up
Ожидаемый результат: прогон зелёный без сети. Если упал, где-то остался реальный вызов внешнего API.
Посмотри логи раннера на предмет ретраев. Если один и тот же тест повторяется, у тебя уже есть кандидат в flaky.
grep -c "RETRY" /var/log/ci/runner.log
grep -E "FAILED|ERROR" /var/log/ci/runner.log | sort | uniq -c | sort -rn | head
Ожидаемый результат: список тестов с частотой падений. Верх списка это первые кандидаты на разбор.
Осложнения: конкретные ошибки, причины, решения
Дальше самое полезное. Ниже разобраны ошибки, которые я видел в живых прогонах десятки раз. Формат простой: что видишь в логе, почему так, что делать, какой командой проверить. Копируй и подставляй своё.
Ошибка: тест падает на CI, локально проходит
Классика. На раннере другой часовой пояс, меньше памяти, нет доступа к локальному кэшу или сетевому ресурсу. Плюс часто разный порядок выполнения, потому что воркеров больше.
Логируй окружение прямо из теста. Первая строка setup, которая печатает TZ, локаль, версию интерпретатора, хост БД и переменные CI. Дальше сравни две строки вывода рядом. Разница видна сразу.
# вывести окружение прогона
date
echo "TZ=$TZ LANG=$LANG LC_ALL=$LC_ALL CI=$CI"
python -VV
printenv | grep -E 'DATABASE|DB_|TEST_' | sort
Если расхождение в часовом поясе, фиксируй его явно в конфиге CI и в тесте. Не полагайся на системный. Так тест проверяет логику, а не настройки раннера.
# в CI-пайплайне и в Makefile
TZ=UTC
LANG=C.UTF-8
LC_ALL=C.UTF-8
PYTHONHASHSEED=0
Ошибка: assertion failed по дате в прогоне около полуночи
Тест берёт текущую дату, сравнивает с фиксированной строкой в ожиданиях, и в 23:59:59 всё ломается. Причина: код теста читает системное время вместо переданного параметра.
Передавай время аргументом. Любой вызов «сейчас» в тестируемом коде должен идти через функцию clock, которую в тесте ты подменяешь на фиксированную точку.
from datetime import datetime, timezone
from freezegun import freeze_time

@freeze_time("2024-03-15T23:59:59Z")
def test_order_expires():
    # здесь «сейчас» всегда одно и то же
    assert order.expires_at == datetime(2024, 3, 16, 0, 0, tzinfo=timezone.utc)
Проверь, что тест не зовёт datetime.now() напрямую нигде в дереве вызовов. Одна такая строка ломает всё.
Ошибка: тест проходит сам, но валит соседа
Общее изменяемое состояние: одна таблица в БД без транзакции на тест, один файл во временной папке, один счётчик. Пока тесты идут по одному, всё зелёное. В параллели получаешь случайные падения.
Оберни каждый тест в транзакцию и откатывай её после. В pytest это делается фикстурой, в JUnit через @Transactional, в Go через отдельную схему на тест.
import pytest
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker

@pytest.fixture
def db_session():
    engine = create_engine("postgresql://test:test@localhost/testdb")
    conn = engine.connect()
    trans = conn.begin()
    Session = sessionmaker(bind=conn)
    session = Session()
    try:
        yield session
    finally:
        session.close()
        trans.rollback()
        conn.close()
Без транзакции каждый тест оставляет мусор. Через 200 прогонов в таблице накапливаются записи, и логика поиска начинает отдавать не то. Вот тут важно: очистка должна быть частью фикстуры, а не отдельным суицидальным SQL-запросом перед тестом.
Ошибка: тест ждёт ответа 30 секунд и всё равно падает по таймауту
Фиксированная задержка через time.sleep не помогает на загруженном раннере. Тест либо ждёт лишнее, либо недостаточно. Правильно: ждать не время, а условие.
import time

def wait_until(predicate, timeout=10.0, interval=0.1):
    deadline = time.monotonic() + timeout
    while time.monotonic() < deadline:
        if predicate():
            return True
        time.sleep(interval)
    raise TimeoutError("condition not met within %.1fs" % timeout)

wait_until(lambda: client.get_status(job_id) == "done")
Если используешь Playwright или Selenium, они уже умеют ждать по условию. Не смешивай своего sleep с их ожиданиями: получишь непредсказуемый тайминг.
Ошибка: тест зелёный, а в проде регрессия
Проверка кода ответа 200 без тела и побочных эффектов. Тест валиден, пока не меняется формат ответа, пока не меняется содержимое БД, пока не отправляется письмо или не пишется лог. Как только логика сломалась, но статус всё ещё 200, тест молчит.
Проверяй минимум: код ответа, схему тела, ключевые поля и, если применимо, состояние БД после запроса.
resp = client.post("/api/orders", json=payload)
assert resp.status_code == 201
body = resp.json()
assert body["id"]
assert body["status"] == "pending"

row = db.execute(
    "select status, total from orders where id = %s", (body["id"],)
).fetchone()
assert row.status == "pending"
assert row.total == payload["total"]
Один тест на happy-path без проверки тела стоит меньше, чем ноль тестов. Он даёт ложную уверенность.
Ошибка: тест валится по Permission denied только в CI
Прогон от root маскирует ошибки прав. Локально ты запускаешь от своего пользователя, а на раннере в контейнере по умолчанию root. Файлы и сокеты создаются с правами, которых у обычного пользователя в проде не будет.
Всегда гоняй тесты от непривилегированного пользователя. В Dockerfile создай пользователя и переключись.
FROM python:3.12-slim
RUN useradd -m -u 1000 tester
USER tester
WORKDIR /home/tester/app
COPY --chown=tester:tester . .
RUN pip install --user -r requirements.txt
Проверка простая: тест от root и тест от tester дают одинаковый результат. Если нет, у тебя проблема прав, а не логики.
Ошибка: тест работает на localhost, но не работает с прод-БД
Отсутствие изоляции. Переменная DATABASE_URL случайно указывает на продакшн, и тест «успешно» пишет данные в живую таблицу. Один такой прогон стирает часть данных, потом реверс из бэкапа, потом объяснения с бизнесом.
Защита ставится на уровне приложения и на уровне БД. Приложение отказывается работать, если URL указывает на прод-хост. БД выдаёт пользователю тестов только узкий грант.
import os

FORBIDDEN_HOSTS = {"prod-db.internal", "db.example.com"}
url = os.environ["DATABASE_URL"]
if any(h in url for h in FORBIDDEN_HOSTS) and not os.environ.get("ALLOW_PROD_FOR_TESTS"):
    raise RuntimeError("refuse to connect tests to production database")
-- для тестового пользователя никаких прав на основной инстанс
CREATE USER tester WITH PASSWORD 'strong-pass-here';
CREATE DATABASE testdb OWNER tester;
REVOKE ALL ON DATABASE prod FROM tester;
Двухфакторная защита: явная проверка хоста в коде и отсутствие доступа на уровне БД. Если что-то одно проглядели, второе спасёт.
Ошибка: тест на производительность не сходится между прогонами
Раннер с разным CPU, параллельные воркеры, разная нагрузка на соседей в кластере. Результат одного прогона отличается от другого в разы.
Фиксируй ресурсы: количество CPU, объём памяти, число воркеров, размер датасета. Сравнивай не абсолют, а границы: «время ответа не больше 120 мс на p95». Иначе получишь цифры, которые ничего не значат.
| Параметр | Плохо | Хорошо |
|---|---|---|
| CPU | «сколько дадут» | 2 vCPU фиксировано |
| Память | без лимита | 2048 MiB |
| Воркеры | авто | 4 |
| Датасет | 100 записей | 100000 записей, зафиксировано |
| Метрика | среднее | p95 и p99 |
Ошибка: тест на кириллицу падает по кодировке
Локаль C, чтение файлов в ASCII, ответ API разбирается байтами без декодирования. Строка «Отчёт» превращается в мусор, сравнение не сходится.
Ставь C.UTF-8 в CI и в контейнере. Явно указывай кодировку при чтении и записи файлов. Не полагайся на локаль по умолчанию.
with open("fixture.txt", "r", encoding="utf-8") as f:
    data = f.read()

resp = client.get("/api/report")
assert resp.encoding == "utf-8"
assert "Отчёт" in resp.text
Проверь, что клиент не перезаписывает encoding наугад. И что база отдаёт текст в UTF-8, а не в WIN1251.
Альтернативы: чем можно заменить ручную стабилизацию
Иногда переписывать фикстуры и разбирать плавающие тесты слишком дорого. Есть другие пути. Ниже что применяют и когда это оправдано.
Retry на уровне теста
Автоматический повтор при падении. Быстро внедрить, не требует анализа. Минус: маскирует настоящую проблему. Если тест валится 1 раз из 10, retry с 3 попытками вылечит симптом, а причина никуда не денется.
import pytest

@pytest.mark.flaky(reruns=3, reruns_delay=2)
def test_external_api_call():
    assert client.get("/health").status_code == 200
Retry применяй как временную меру на тестах, которые трогают внешние сервисы. Не применяй на тестах собственной логики. Там падение это сигнал, а не шум.
Карантин плавающих тестов
Тест помечается как необязательный, выпадает из общего скора, но продолжает запускаться. Команда видит, что он падает, но CI не блокирует merge.
@pytest.mark.quarantine
def test_legacy_import():
    """
    Известно нестабилен. Разбор в задаче TICKET-1234.
    """
    assert importer.run()
Это работает, если есть срок. Тест в карантине с открытым тикетом и дедлайном. Без срока карантин превращается в свалку, где тесты живут годами и никто их не смотрит.
Testcontainers и одноразовая БД на каждый прогон
Вместо общей тестовой БД каждый прогон поднимает свежий контейнер. Полная изоляция, никаких остатков от предыдущего запуска. Цена: медленнее старт, нужен Docker на раннере.
from testcontainers.postgres import PostgresContainer
import pytest

@pytest.fixture(scope="session")
def postgres():
    with PostgresContainer("postgres:16-alpine") as pg:
        yield pg.get_connection_url()
Если у тебя 500 тестов и общая схема, testcontainers экономят время на разборе «почему у меня падает, а у тебя нет». Старт контейнера это секунды, разбор плавающего теста это часы.
Запуск только затронутых тестов
Вместо полного прогона на каждый коммит запускай только тесты, относящиеся к изменённым файлам. Быстрее, меньше шанс наткнуться на случайное плавающее падение в далёком модуле. Минус: легко пропустить интеграционные связи.
# пример через git diff и маппинг модулей
CHANGED=$(git diff --name-only origin/main...HEAD | grep '^app/' || true)
if [ -n "$CHANGED" ]; then
  pytest $(echo "$CHANGED" | sed 's|^app/|tests/|;s|\.py$||') --quiet
fi
Полный прогон всё равно нужен, но раз в сутки на nightly, а не на каждый push.
Что выбрать
| Ситуация | Рекомендация |
|---|---|
| Отдельные внешние зависимости | Retry с ограничением 3 попытки |
| Плавающий тест в чужом модуле | Карантин с тикетом и дедлайном |
| Много общих данных между тестами | Testcontainers или отдельная схема на тест |
| Долгий полный прогон | Инкрементальный запуск плюс nightly полный |
Основной путь всё равно один: изоляция на уровне данных, ожидание по условию вместо sleep, фиксированное окружение. Остальное это временные костыли. Применяй их только пока лечишь корень.
Профилактика: как удержать стабильность
Мониторинг плавающих тестов
Плавающие тесты надо ловить не в момент, когда CI заблокирован, а раньше. Два подхода. Первый: хранить историю прогонов и считать долю падений на неизменённом коде. Второй: периодически гонять весь набор N раз подряд без изменений и смотреть, что отвалилось.
# 5 повторов одного теста, чтобы поймать недетерминизм
for i in 1 2 3 4 5; do
  pytest tests/test_orders.py::test_expires -q || echo "run $i failed"
done
Тест, который валится 1 раз из 5 при неизменённом коде, это уже flaky. Его в карантин и разбираться, пока не превратился в ежедневную боль.
# отдельный nightly-джоб: повторный прогон без изменений
for run in 1 2 3 4 5 6 7 8 9 10; do
  pytest --tb=no -q 2>&1 | tee /var/log/ci/nightly-$run.log
done
grep -h "FAILED" /var/log/ci/nightly-*.log | sort | uniq -c | sort -rn | head -20
Список топ-20 по числу падений это твой todo на неделю. Разбирай сверху вниз, а не «где-нибудь поищу плавающее».
Бэкапы тестовой инфраструктуры
Что бэкапить: конфигурации CI (workflow-файлы, пайплайны, реестр секретов), скрипты запуска, тестовые БД-схемы и датасеты фикстур. Не бэкапь сам результат прогонов, только входные данные.
Как часто: конфигурации CI при каждом изменении в git (по факту git и есть бэкап, но реплика в отдельное хранилище не помешает), тестовые датасеты раз в сутки, снапшот тестовой БД раз в сутки перед nightly.
Где хранить: отдельный бакет S3 или аналог, другая учётка, другой регион. Без доступа из прод-контура. Тогда случайное удаление или компромисс в одном контуре не убьёт оба.
# ежедневный бэкап тестовой БД в отдельный бакет
DATE=$(date -u +%Y-%m-%d)
pg_dump -h test-db.internal -U tester testdb \
  | gzip > /tmp/testdb-$DATE.sql.gz
aws s3 cp /tmp/testdb-$DATE.sql.gz \
  s3://ci-backups/testdb/testdb-$DATE.sql.gz \
  --storage-class STANDARD_IA
rm /tmp/testdb-$DATE.sql.gz
Восстановление проверяй. Раз в квартал подними тестовую БД из дампа в изолированном окружении и запусти на ней полный набор. Если восстановление не тестировалось, оно не работает.
# восстановление из дампа
gunzip -c testdb-2024-03-15.sql.gz | psql -h test-db.internal -U tester testdb
Автозапуск: nightly, хаос-режим, повторы
Три вещи, которые должны работать сами. Nightly полный прогон, nightly повторный прогон для выявления flaky, еженедельный прогон с искусственными задержками и падениями mock-сервисов.
# .github/workflows/nightly.yml (фрагмент)
on:
  schedule:
    - cron: '0 2 * * *'   # полный прогон в 02:00 UTC
    - cron: '0 4 * * *'   # повторный прогон для выявления flaky
jobs:
  full:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: TZ=UTC LANG=C.UTF-8 pytest -q
Хаос-режим простой: в тестовом окружении добавь прокси перед внешним сервисом, который с вероятностью 5% рвёт соединение и с вероятностью 5% отвечает с задержкой 5 секунд. Если твои тесты это переживают без retry, значит ожидания построены правильно.
Безопасность тестового окружения
Тестовые секреты не должны совпадать с прод-секретами. Отдельные ключи API, отдельные токены, отдельные пользователи БД. Прод-ключи в тестах это способ утечь наружу через форк PR.
Изоляция сети: тестовое окружение без выхода в интернет, кроме белого списка доменов для зависимостей. Тогда случайный вызов внешнего сервиса либо сработает по явному правилу, либо упадёт сразу, а не будет втихую ходить куда-то месяцами.
# пример политики сети для CI-раннера (фрагмент)
# разрешено: pypi.org, registry.npmjs.org, твой внутренний registry
# запрещено: всё остальное, включая *.amazonaws.com и *.googleapis.com
Права в CI: рабочий токен с минимальным набором scope. Если пайплайну нужен только доступ к артефактам, не выдавай ему права на пуш в основные ветки.
Обновление инструментария и откат
Обновляй версии интерпретатора, тестового фреймворка, драйверов БД отдельными PR. Никогда не мешай их с логическими изменениями: если сломалось, непонятно, что именно.
Проверь до обновления: список deprecated-функций, которые ты реально используешь, поведение случайных значений и порядка тестов в новой версии, время полного прогона. После обновления сравни метрики: сколько тестов было и сколько стало, время до и после.
# зафиксировать baseline перед апгрейдом
pytest --collect-only -q | tail -1 > baseline_count.txt
time pytest -q 2>&1 | tail -3 > baseline_time.txt
cat baseline_count.txt baseline_time.txt
Откат: пин версий в requirements.txt или pyproject.toml. Если апгрейд сломал что-то непонятное, откатись к зафиксированным версиям, разберись в изолированной ветке, потом возвращайся.
# requirements.txt
pytest==8.2.2
pytest-xdist==3.6.1
freezegun==1.5.1
testcontainers==4.7.2
sqlalchemy==2.0.30
Пин версии держи в git. Обновление зависимостей это отдельная задача, а не побочный эффект срочного фикса.
FAQ: вопросы из «Люди также спрашивают»
Почему тесты падают на CI, а локально проходят?
Первое, что проверь: часовой пояс, локаль, версия интерпретатора, доступ к внешним сервисам, число воркеров и порядок выполнения. На раннере обычно TZ=UTC, локаль C, ресурсы ограничены, нет доступа к твоему локальному кэшу или конфигу. Вторая причина: тесты зависят от общего состояния на твоей машине (файлы, переменные окружения, локальная БД с данными от ручных прогонов), а на чистом раннере этого нет. Третья: сетевые запросы из CI идут по другим маршрутам и могут утыкаться в корпоративный прокси или файрвол. Сравни вывод окружения из теста на двух машинах: обычно разница видна в первых десяти строках.
Как найти плавающий тест?
Гоняй набор несколько раз подряд без изменений кода и собирай статистику. Тест, который в одном прогоне зелёный, а в другом падает при том же коммите, это flaky. Пара команд для этого: цикл из 5-10 прогонов и агрегация по логам. Плюс проверь пин версий: иногда flaky появляется после минорного апгрейда фреймворка. Помечай найденные тесты, добавляй им метаданные с причиной и дедлайном разбора. Список из 20 тестов сверху по числу падений это твой рабочий план.
for i in $(seq 1 10); do
  pytest -q --tb=no -p no:cacheprovider 2>&1 | grep -E "FAILED|ERROR" \
    | sed "s/^/run$i /" >> flaky.txt
done
cut -d' ' -f2- flaky.txt | sort | uniq -c | sort -rn | head -20
Как изолировать тестовую базу от продакшена?
Два уровня защиты. На уровне приложения: явная проверка хоста БД в стартовом коде, отказ работать, если хост похож на прод. На уровне БД: отдельный пользователь для тестов, отдельная база, никаких грантов на прод-инстанс. Дополнительно: разные пароли и разные секреты в CI и в проде. Тогда даже если кто-то случайно скопирует конфиг, доступа к прод-базе не будет.
Почему автотесты зависят от даты и времени и как это исправить?
Потому что тестируемый код читает текущее время напрямую. Исправляется подменой источника времени: в Python это freezegun или pytest-freezegun, в Java Clock.fixed, в Go интерфейс с методом Now(). Любой вызов «сейчас» должен идти через инъекцию. После правки тест работает в прогоне около полуночи, при смене часового пояса, при прогоне в отпуске и при прогоне в день смены летнего времени.
Как убрать sleep из тестов?
Замени фиксированную задержку на ожидание условия. Напиши функцию wait_until с таймаутом и интервалом опроса. Она проверяет предикат и выходит, как только условие выполнено, а не спит всегда по 5 секунд. Это и быстрее, и стабильнее. Если тестируемый код на Selenium или Playwright, используй их встроенные ожидания. Смешивать свои sleep с ожиданиями фреймворка не надо: получишь непредсказуемый тайминг и ложные падения.
Что делать, если тест проверяет только код ответа?
Дополнить: минимум проверка схемы тела ответа, ключевых полей и состояния БД после запроса. Тест, который проверяет только 200, ловит только падение сервиса. Логику он не проверяет. Добавь проверку кода ответа, ключевых полей JSON, и один SELECT в БД, подтверждающий побочный эффект. Это дешевле, чем ловить регрессию в продакшене после релиза.
Как запускать тесты не от root?
Создай отдельного пользователя в образе или на раннере и переключись на него. Конкретно: в Dockerfile через директивы RUN useradd и USER tester, локально через su или через sudo -u tester pytest. Прод-код работает от непривилегированного пользователя, значит тесты тоже должны. Разница в правах на файлы, сокеты, порты и системные вызовы видна только когда ты не root.
Чем заменить фиксированные задержки в тестах?
Ожиданием условия через функцию с таймаутом. Это подходит и для проверки, что запись появилась в БД, и для проверки, что задача завершилась. Если тестируешь внешний сервис, ставь прокси-заглушку, которая отвечает предсказуемо и мгновенно. В крайнем случае, если ничего не помогает, оставь один sleep с явным комментарием, почему он тут и почему его нельзя убрать иначе. Но это должно быть исключением, а не правилом.
Прогноз
Если ты закрыл изоляцию БД, переписал sleep на ожидание условия, зафиксировал TZ, локаль и версии инструментов, у тебя останется 5-10 процентов падений от тех, что были раньше. Оставшиеся почти все окажутся в двух категориях: внешние сервисы без mock и тесты с общим изменяемым состоянием. Обе категории чинятся отдельной задачей без переделки всего набора. Плюс появится предсказуемость: ты смотришь в CI и понимаешь, зелёный он потому что код в порядке, а не потому что тесты прошли случайно.
На этом же этапе имеет смысл завести ночной джоб на повторные прогоны. Пара недель статистики покажет, где ещё остались плавающие тесты, и ты будешь разбирать их точечно, а не разгребать в момент срочного релиза. Спокойный разбор всегда дешевле пожара.

Author: Александра Сергеевна
Оставайтесь на связи
Рецепты от IT-боли. Без воды, без рекламы, без маркетинговой шелухи.
Подписаться на IT-Аптеку →


Вот с фиксацией времени не до конца ясно. У меня тест на удаление записей старше 30 дней. Оборачиваю в freezegun, ставлю конкретную дату, все ок. Но у нас в коде есть фоновый воркер, который сам раз в сутки дергает очистку. И когда я запускаю тесты локально в 23:50, воркер может сработать прямо посреди теста и удалить записи, которые я в фикстуре создал. Как ты изолируешь фоновые задачи от основного теста? Просто мокнуть вызов целиком или запускать воркер в отдельном процессе с общим временем? Никак не пойму, где тут правильная граница изоляции.
Тут собака зарыта не во времени, а в том, что воркер у тебя живет в том же процессе и смотрит на те же данные. freezegun двигает часы только в текущем интерпретаторе, поэтому если воркер запускается отдельным процессом или через celery beat, он про подмену не знает и работает по системному времени. Отсюда удаление посреди теста.
Правильная граница простая: в юнит и интеграционных тестах ты не проверяешь планировщик, ты проверяешь логику очистки. Значит, вызов планировщика мокается целиком, тест дергает функцию очистки руками с переданным now. Так у тебя один источник времени и нет гонок.
Проверить, что воркер не стреляет, можно так: запусти pytest с флагом -p no:randomly и посмотри, в каком процессе крутится таска через ps -ef | grep celery. Если в отдельном, freezegun до нее не достает. Для проверки самого расписания заведи отдельный тест на beat schedule и сравни cron-выражение, без реального запуска.
Не смешивай в одном прогоне проверку логики и проверку планировщика. Это два разных теста, и падают они по разным причинам.
Затык на шаге 3. Оборачиваю тест в транзакцию и откатываю, но один тест всё равно падает после соседнего. Ощущение, будто откат не сработал, хотя база как будто чистая. Можешь на пальцах объяснить, почему транзакция не всегда возвращает базу в исходное состояние? В быту это как будто помыл чашку, а на стенках всё равно остался след. Что именно может утечь наружу и как это поймать без чтения километров документации?
Транзакция откатывает данные, но не откатывает то, что живёт вне транзакции. У PostgreSQL есть три вещи, которые переживают ROLLBACK: последовательности (они не транзакционные), изменения схемы, сделанные через DDL, и NOTIFY/LISTEN. Ещё один источник утечки: если код под тестом коммитит сам, вложенный commit закрывает твою транзакцию, и откат уходит в пустоту. Проверяется быстро: перед тестом и после него выполни SELECT last_value FROM имя_последовательности и сравни. Если значение уехало, чисти последовательности через ALTER SEQUENCE … RESTART WITH 1 в фикстуре. Ещё сними автокоммит на уровне драйвера: в psycopg2 это conn.autocommit = False, иначе каждый execute стартует свою транзакцию. Если тест использует асинхронный клиент, проверь, что он не гоняет запросы через пул соединений с автосбросом. Для отлова вставь в фикстуру запрос к information_schema.tables на список таблиц и сравнивай количество строк до и после. Обычно ловится один тест, который оставляет за собой запись в справочнике.