

1. Проверь, что датчики вообще читаются: ipmitool sensor, sensors, smartctl -A.
2. Загрузи модули ядра IPMI и прогони sensors-detect, если вывод пустой.
3. Собери метрики в текст через node_exporter textfile или сторонний экспортёр.
4. Заведи алерты на Upper Critical из IPMI и на свой порог для дисков.
5. Проверь срабатывание алерта принудительно, до реального перегрева.
Диагноз: датчики есть, а ты о них не знаешь
Сервер гудит как пылесос. В логах thermal throttle. Или вообще внезапный ребут в три часа ночи без единой строчки в syslog. А мониторинг температуры сервера при этом показывает ровно ничего, потому что его никто не настроил. Знакомо.
Проблема почти всегда не в отсутствии датчиков. Датчики на серверном железе есть. Проблема в том, что их показания никто не читает и оповещений о перегреве сервера нет. Производитель выставил пороги, ты их не видишь. IPMI пишет SEL, ты туда не смотришь. Диск греется до 60 градусов, SMART молчит, потому что ты его не опрашиваешь.
Что будет в этой части:
- Как проверить, какие датчики реально доступны на твоём железе.
- Как поднять ipmitool и lm-sensors с нуля, включая модули ядра.
- Как снимать температуру дисков через SMART и NVMe.
- Как выгрузить всё это в метрики для Prometheus.
- Как поставить оповещения и проверить их срабатывание.
Время: от 40 минут на одном сервере, если железо отдаёт данные. Нужны root-доступ, установленный Prometheus с Alertmanager или Zabbix, и понимание, где живёт твой конфиг мониторинга. Если Prometheus у тебя нет, ниже будет альтернатива на голом cron и почте, но основной рецепт под метрики.
Отдельно про виртуалки. На большинстве VM физических датчиков нет. Не удивляйся пустому выводу. Мониторить надо хост, а не гостя.
Почему датчики не читаются и оповещения не приходят
Семь причин, с которыми я сталкивался чаще всего.
1. Модули ядра IPMI не загружены
Без ipmi_si и ipmi_devintf устройства /dev/ipmi0 нет. ipmitool падает с ошибкой открытия устройства. На многих серверах модули не грузятся автоматически.
2. lm-sensors не видит чип без драйвера
lm-sensors показывает только те датчики, чьи драйверы загружены. Нет модуля coretemp, k10temp или nct6775 для твоей платы, значений не будет. Пустой вывод sensors это не поломка, это отсутствие драйвера.
3. Пороги IPMI не выставлены производителем
Значения Upper Critical и Upper Non-Recoverable производитель ставит не всегда. Если порога нет, мониторинг по порогу не сработает: сравнивать не с чем. Приходится задавать свой порог.
4. coretemp занижен, а VRM и диски не видно вообще
Датчик coretemp на CPU показывает температуру с погрешностью и не отражает нагрев VRM, чипсета и дисков. Если мониторить только CPU, проблему с диском ты пропустишь.
5. Диски отдают температуру не всегда
S.M.A.R.T. читается через smartctl или nvme smart-log, но USB-накопители и часть RAID-контроллеров эти данные не отдают. За контроллером температура дисков не видна без утилит производителя.
6. IPMI не успевает записать SEL при коротком скачке
При кратковременном превышении порога IPMI может не успеть отправить SEL-запись. Сработает только аппаратный thermal throttle или аварийное выключение. Ты узнаешь о проблеме, когда она уже случилась.
7. node_exporter температуру не собирает из коробки
Стандартный node_exporter не отдаёт температуру. Нужны текстовые коллекторы или сторонние экспортёры. Без этого в Grafana будет пусто.
Рецепт: сбор температуры и оповещения за один проход
Подготовка
Проверь три вещи до начала: что за железо, есть ли IPMI, доступен ли SMART.
dmidecode -t system | grep -E "Manufacturer|Product"
ipmitool mc info 2>&1 | head -5
ls -l /dev/ipmi0 /dev/ipmi/0 2>&1
which smartctl sensors ipmitool node_exporter
Ожидаемо: увидишь модель сервера, ответ IPMI-контроллера, наличие устройства и всех утилит. Если ipmitool mc info ругается на отсутствие устройства, переходи к загрузке модулей.
Системные требования
| Компонент | Версия | Примечание |
|---|---|---|
| ОС | Ubuntu 22.04 / 24.04 LTS | На Debian 12 тоже работает |
| ipmitool | актуальная на момент написания, проверь релизы | пакет ipmitool |
| lm-sensors | актуальная на момент написания, проверь релизы | пакет lm-sensors, не входит в базовую установку Ubuntu |
| smartmontools | актуальная на момент написания, проверь релизы | пакет smartmontools |
| node_exporter | актуальная на момент написания, проверь релизы | только для варианта с Prometheus |
| Prometheus + Alertmanager | актуальная на момент написания, проверь релизы | внешняя система мониторинга |
На момент публикации актуальна версия по каждому пакету из своего канала. Перед установкой проверь свежие релизы.
Установка
apt update
apt install -y ipmitool lm-sensors smartmontools
Безопасность на этапе настройки
IPMI это отдельный сетевой интерфейс, часто с дефолтным паролем. Если контроллер торчит в общую сеть, это подарок сканеру. Проверь, куда смотрит IPMI, и закрой его на интерфейс управления или ACL. Модуль ядра IPMI открывает /dev/ipmi0 с правами root: не давай обычным пользователям доступ к устройству. Пароли IPMI и API-ключи мониторинга не храни в открытом виде в репозитории конфигов, вынеси в переменные окружения или secrets-файл с правами 600.
Шаг 1. Загрузка модулей IPMI
Без модулей ipmitool не работает. Загружаем и делаем постоянными.
modprobe ipmi_si
modprobe ipmi_devintf
ls -l /dev/ipmi0
Ожидаемо: файл /dev/ipmi0 появился, права root root. Проверь живность контроллера:
ipmitool sensor list | head -20
Ожидаемо: список датчиков с текущим значением, единицами и порогами. Если список пустой, попробуй ipmitool -I open sensor list или -I lanplus -H <ipmi-ip> -U <user> -P <pass> sensor list. Второй вариант нужен, если локального доступа нет, а IPMI доступен по сети.
Для автоматической загрузки модулей при старте:
cat >> /etc/modules <<EOF
ipmi_si
ipmi_devintf
EOF
Шаг 2. lm-sensors и повторный sensors-detect
lm-sensors на Ubuntu не настраивается сам. После обновления ядра модули могут отвалиться, и вывод снова станет пустым. Прогоняем детект.
sensors-detect --auto
sensors -u
Ожидаемо: список чипов и датчиков с температурой в миллиградусах. Если вывод пустой, ядру нечего показать: нет драйвера. Проверь, какие модули загружены, и есть ли среди них нужный для твоей платы.
lsmod | grep -E "coretemp|k10temp|nct|it87"
sensors
Помни: coretemp часто занижен, а VRM и чипсет через него не видны. Для полной картины по железу опирайся на IPMI.
Шаг 3. Температура дисков через SMART
SATA и SAS отдают температуру через атрибут 194 или 190. NVMe через отдельный ключ. Проверь оба типа.
smartctl -A /dev/sda | grep -iE "temperature|Airflow"
nvme smart-log /dev/nvme0 | grep -i temperature
Ожидаемо: строка с температурой в градусах Цельсия. Если пусто и диск за RAID-контроллером, попробуй smartctl -d megaraid,N -A /dev/sdX или утилиту производителя. USB-накопители, скорее всего, ничего не отдадут.
Шаг 4. Выгрузка метрик в node_exporter
node_exporter не собирает температуру сам. Используем textfile-коллектор. Пишем скрипт, который кладёт метрики в каталог /var/lib/node_exporter/textfile с расширением .prom, а планировщик запускает его по расписанию.
mkdir -p /var/lib/node_exporter/textfile
cat > /usr/local/bin/collect-temp.sh <<'EOF'
#!/bin/bash
OUT=/var/lib/node_exporter/textfile/temp.prom
TMP=$(mktemp)
echo "# HELP server_temperature_celsius Температура датчиков" >> "$TMP"
echo "# TYPE server_temperature_celsius gauge" >> "$TMP"

ipmitool sensor list 2>/dev/null | awk -F'|' '
{
  gsub(/ /,"",$1); gsub(/ /,"",$2);
  if ($2 ~ /^[0-9.]+$/) print "server_temperature_celsius{sensor=\""$1"\",source=\"ipmi\"} "$2
}' >> "$TMP"

sensors -u 2>/dev/null | awk '
/temp[0-9]+_input:/ {
  gsub(/:/,""); name=$1; val=$2/1000;
  print "server_temperature_celsius{sensor=\""name"\",source=\"lmsensors\"} "val
}' >> "$TMP"

for d in /dev/sd?; do
  t=$(smartctl -A "$d" 2>/dev/null | awk '/Temperature_Celsius|Airflow_Temperature/{print $10; exit}')
  [ -n "$t" ] && echo "server_temperature_celsius{sensor=\"$(basename $d)\",source=\"smart\"} $t" >> "$TMP"
done

for n in /dev/nvme?; do
  t=$(nvme smart-log "$n" 2>/dev/null | awk '/^temperature/{print $3; exit}')
  [ -n "$t" ] && echo "server_temperature_celsius{sensor=\"$(basename $n)\",source=\"nvme\"} $t" >> "$TMP"
done

mv "$TMP" "$OUT"
EOF
chmod +x /usr/local/bin/collect-temp.sh
Запусти раз вручную и посмотри, что получилось.
/usr/local/bin/collect-temp.sh
cat /var/lib/node_exporter/textfile/temp.prom
Ожидаемо: набор строк вида server_temperature_celsius{sensor="CPU1_Temp",source="ipmi"} 42. Оптимизация: скрипт делает несколько вызовов smartctl, что на сервере с десятью дисками не бесплатно. Если дисков много, вынеси сбор дисков в отдельный запуск раз в пять минут.
Расписание через systemd timer, а не cron: проще логи и зависимости.
cat > /etc/systemd/system/collect-temp.service <<'EOF'
[Unit]
Description=Collect server temperatures

[Service]
Type=oneshot
ExecStart=/usr/local/bin/collect-temp.sh
EOF

cat > /etc/systemd/system/collect-temp.timer <<'EOF'
[Unit]
Description=Run temperature collector every minute

[Timer]
OnBootSec=30
OnUnitActiveSec=60
Unit=collect-temp.service

[Install]
WantedBy=timers.target
EOF

systemctl daemon-reload
systemctl enable --now collect-temp.timer
Шаг 5. Промышленный сбор через IPMI-экспортёр
Если серверов много, самописный скрипт на каждом станет болью. Бери готовый prometheus-ipmi-exporter. Он сам опрашивает IPMI по lanplus и отдаёт пороги вместе со значением. В рецепте оставил текстовый коллектор, потому что он работает там, где IPMI-экспортёр не заводится из-за прав или сети. Для парка серверов выбирай экспортёр.
Шаг 6. Оповещения в Alertmanager
Правило: срабатывать на Upper Critical из IPMI и на своём пороге для дисков. Пороги IPMI ты уже видишь в выводе. Где их нет, ставь свой порог, например 75 градусов для CPU и 55 для дисков.
cat > /etc/prometheus/rules/temperature.yml <<'EOF'
groups:
  - name: temperature
    rules:
      - alert: ServerTempCritical
        expr: server_temperature_celsius > 75
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Температура {{ $labels.sensor }} выше 75"
          description: "Источник {{ $labels.source }}, текущее {{ $value }}C"

      - alert: DiskTempHigh
        expr: server_temperature_celsius{source=~"smart|nvme"} > 55
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Диск {{ $labels.sensor }} греется"
EOF
Ожидаемо: Prometheus подхватит правило после reload, Alertmanager начнёт отдавать алерты в настроенный канал. Проверь синтаксис до перезагрузки.
promtool check rules /etc/prometheus/rules/temperature.yml
systemctl reload prometheus
Шаг 7. Принудительная проверка алерта
Не жди реального перегрева. Временный файл с фиктивной высокой температурой проверит всю цепочку за минуту.
echo 'server_temperature_celsius{sensor="TEST",source="manual"} 99' > /var/lib/node_exporter/textfile/test.prom
Ожидаемо: через две минуты алерт ServerTempCritical станет firing, Alertmanager отправит сообщение в твой канал. Убери файл.
rm /var/lib/node_exporter/textfile/test.prom
Архитектура сбора
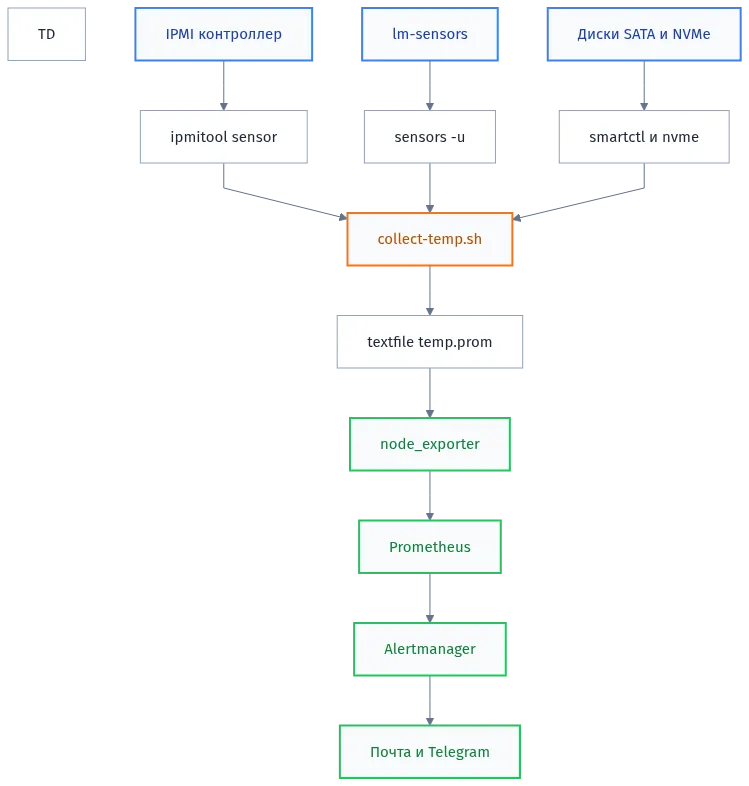
Таблица портов
| Порт | Протокол | Назначение | Доступен снаружи |
|---|---|---|---|
| 623 | UDP | IPMI lanplus | нет, только из сети управления |
| 9100 | TCP | node_exporter | нет, только для Prometheus или через SSH-туннель |
| 9090 | TCP | Prometheus веб и API | нет, только для внутренних сервисов |
| 9093 | TCP | Alertmanager API | нет, только для Prometheus |
Порт 623 по IPMI открывать во внешнюю сеть нельзя ни при каких условиях. Контроллер живёт на отдельном интерфейсе, часто с дефолтным паролем, и это классический вход в железо.
Проверка: работает ли мониторинг температуры
Прогони по порядку. Если каждый пункт даёт ожидаемый результат, сбор настроен.
Устройство IPMI на месте
ls -l /dev/ipmi0
ipmitool mc info | grep -E "Firmware|Manufacturer"
Ожидаемо: устройство есть, контроллер отвечает версией прошивки.
Датчики читаются
ipmitool sensor list | awk -F'|' '{print $1, $2, $4}' | head -15
sensors | head -20
Ожидаемо: список датчиков с температурой и единицами. Пусто означает отсутствие драйвера или доступа.
Метрики уходят
curl -s localhost:9100/metrics | grep server_temperature_celsius | head
Ожидаемо: строки с метриками и метками sensor и source. Пусто значит node_exporter не подхватил textfile-каталог. Проверь флаг --collector.textfile.directory в юните node_exporter.
Планировщик живой
systemctl status collect-temp.timer
systemctl list-timers | grep collect-temp
Ожидаемо: таймер активен и указывает время следующего запуска в пределах минуты.
Prometheus видит правило
promtool check rules /etc/prometheus/rules/temperature.yml
curl -s localhost:9090/api/v1/rules | grep ServerTempCritical
Ожидаемо: правило валидно и присутствует в API. Если Prometheus его не видит, проверь путь в конфиге и сделан ли reload.
Алерт доходит
Повтори трюк с test.prom и убедись, что сообщение пришло в канал. Убери файл после проверки. Без этого шага ты узнаешь, что канал не работает, ровно в момент реального перегрева.
echo 'server_temperature_celsius{sensor="TEST",source="manual"} 99' > /var/lib/node_exporter/textfile/test.prom
sleep 130
curl -s localhost:9093/api/v2/alerts | grep -i ServerTempCritical
rm /var/lib/node_exporter/textfile/test.prom
Ожидаемо: в списке алертов Alertmanager есть ServerTempCritical в состоянии firing. Если нет, смотри логи Alertmanager и маршрутизацию в конфиге.
Что ломается, когда датчики уже настроены
Сбор метрик запущен, графики рисуются, и тут наступает второй акт. Датчики отдают мусор, пороги пустые, оповещения не приходят. Ниже разбор реальных ошибок, которые я ловил на продакшне чаще остальных. Для каждой: симптом, причина, решение, команда проверки.
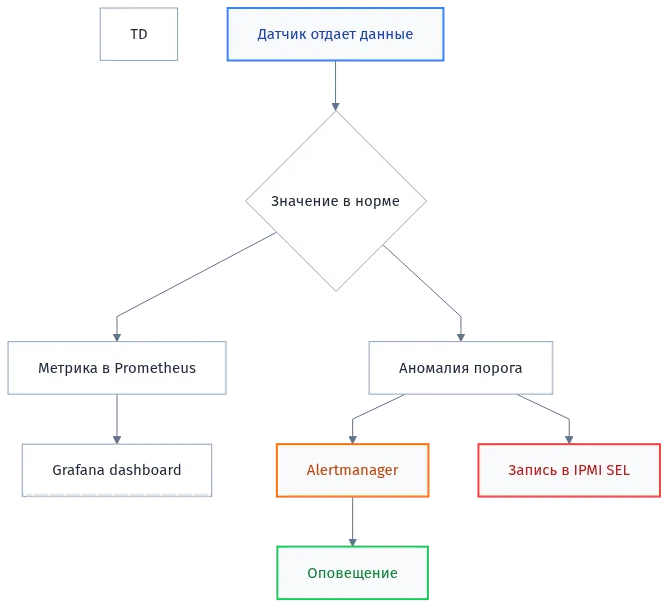
Ошибка: ipmitool sensor возвращает пустоту или No sensor data
Самая частая жалоба. Команда отрабатывает без ошибки, а строк с температурой нет.
Причина: модуль ipmi_si не загружен или загружен с неверным типом интерфейса. Драйвер не нашёл KCS-порт на материнке. Иногда мешает другое ядро после обновления, где модуль не собрался под новую версию.
Проверь, загружен ли модуль и есть ли устройство:
lsmod | grep ipmi
ls -l /dev/ipmi0
dmesg | grep -i ipmi
Если /dev/ipmi0 нет, грузи модуль вручную и смотри на ошибки в dmesg:
modprobe ipmi_si
modprobe ipmi_devintf
modprobe ipmi_poweroff
dmesg | tail -30
Когда в dmesg видишь Unable to find any System Interface found, попробуй указать тип интерфейса явно. Для большинства серверов это kcs:
modprobe -r ipmi_si
modprobe ipmi_si type=kcs ports=0xca8 tryacpi=off
Чтобы модуль грузился при старте, добавь параметры в modprobe.d. Без этого после ребута всё вернётся в исходное состояние:
# /etc/modprobe.d/ipmi.conf
options ipmi_si type=kcs ports=0xca8 tryacpi=off
update-initramfs -u
Ошибка: lm-sensors пустой вывод в Ubuntu 22.04/24.04
sensors запускается, но все строки серые, значений нет. Или выводит только acpitz с одним неинформативным градусом.
Причина: под нужное железо не загружен драйвер. `coretemp` для Intel, `k10temp` для AMD, `nct6775` для плат с Nuvoton-чипом. `sensors-detect` их находит, но только когда его реально прогнали в первый раз. И при обновлении ядра многие забывают повторить генерацию конфига.
sensors-detect --auto
systemctl restart kmod
sensors
Вывод должен содержать Package id 0 или coretemp-isa. Если в ответе одни ошибки No such device, проверь, определился ли чип вообще:
lspci | grep -i 'ISA\|SMBus'
ls /sys/class/hwmon/
Все каталоги /sys/class/hwmon/hwmon* с файлами temp*_input и есть датчики, которые видит ядро. Пусто там, где нет драйвера.
Ошибка: порог Upper Critical в IPMI не выставлен
Мониторинг настроен на порог 80 градусов, но тревога не срабатывает даже при 90.
Причина: производитель не заполнил защитные пороги в нормальный диапазон. У бюджетных плат и китайских корпусов Upper Critical часто стоит на 127 (по сути отключён) или вовсе не определён. Метрика с этим порогом сравнивается с числом, до которого железо не доживёт.
Посмотри фактические пороги для всех датчиков:
ipmitool sensor list | awk -F'|' '{print $1, $8, $9, $10}'
Если колонки Upper Non-Critical, Upper Critical и Upper Non-Recoverable пусты или равны 127, задай их сам. Значение подбирай консервативно: 75 для CPU, 55 для дисков, 70 для VRM.
ipmitool sensor thresh "CPU1 Temp" upper 70 75 80
ipmitool sensor thresh "CPU1 Temp" unc 65 70 75
ipmitool sensor list | grep "CPU1 Temp"
Вот тут важно: не ставь порог впритык к рабочей температуре. Иначе оповещения пойдут каждую минуту, и ты быстро перестанешь их замечать.
Ошибка: S.M.A.R.T. не показывает температуру диска
smartctl -A /dev/sda отдаёт атрибуты, но строки с Temperature_Celsius нет.
Причина: часть USB-накопителей и RAID-контроллеры не пробрасывают SMART-данные дальше. Диск за HBA без режима passthrough тоже молчит. Samsung и некоторые WD отдают температуру только через NVMe-интерфейс или через отдельный атрибут.
Проверь, виден ли диск вообще с точки зрения SMART:
smartctl -i /dev/sda
smartctl -A /dev/sda | grep -i temp
nvme smart-log /dev/nvme0 | grep -i temp
Если диск за RAID-контроллером, узнай его слот через storcli или MegaCli и опрашивай через контроллер:
storcli /c0/eall/sall show all | grep -i temp
Совсем упрямые диски придётся брать через Redfish или SNMP-обёртку контроллера. Стандартного пути тут нет, и вендор это знает.
Ошибка: node_exporter не собирает температуру из коробки
Все метрики есть, а node_hwmon_temp_celsius пустой, хотя `lm-sensors` в консоли значения отдаёт.
Причина: node_exporter действительно не спускается в hwmon автоматически. Нужен либо флаг включения коллектора, либо отдельный textfile-коллектор. Без флага в конфиге метрик по температуре не будет, как ты его ни перезапускай.
Включаем hwmon-коллектор флагом запуска. Правь unit-файл systemd:
# /etc/systemd/system/node_exporter.service.d/override.conf
[Service]
ExecStart=
ExecStart=/usr/local/bin/node_exporter \
  --collector.hwmon \
  --collector.textfile.directory=/var/lib/node_exporter/textfile
systemctl daemon-reload
systemctl restart node_exporter
curl -s localhost:9100/metrics | grep node_hwmon_temp
Метрика должна появиться с лейблами chip и sensor. По ним дальше строишь алерты в Alertmanager.
Альтернативные способы сбора и оповещения
Основной стек из IPMI, lm-sensors, SMART и Prometheus покрывает 90% задач. Но он не единственный, и в некоторых сценариях лучше сработает что-то другое. Разберу варианты и когда их выбирать.
| Способ | Когда выбирать | Ограничения |
|---|---|---|
| Redfish API | Современные серверы Dell, HPE, Supermicro с BMC | Требует пароль BMC, отдельный экспортёр |
| SNMP с MIB вендора | Уже есть Zabbix и парк сетевого железа | Стандартный MIB температуру не отдаёт |
| Zabbix agent + UserParameter | Zabbix уже развёрнут | Меньше детализации по датчикам |
| Prometheus node_exporter + textfile | Единый стек с Grafana и Alertmanager | Ручная генерация метрик скриптом |
| Telegraf + outputs.prometheus | Уже используешь Telegraf для других задач | Плагин ipmi собирает не всё |
| Netdata | Быстро поднять, один хост | Алерты сложнее кастомизировать |
Redfish забирает всё через HTTPS и JSON, обходит проблемы с модулями ядра и KCS-портом. Если BMC отвечает, этот путь стабильнее IPMI. Смотри документацию твоего вендора: у Dell это iDRAC Redfish API, у HPE iLO 5 Redfish. Экспортёр redfish_exporter от Prometheus community конвертирует это в метрики.
SNMP удобен тем, что у тебя уже может быть Zabbix и он всё это умеет. Подвох в MIB. Стандартный SNMPv2-MIB температуру не содержит. Нужен вендорный: Dell OpenManage MIBs, HPE iLO MIB, Supermicro MIB. Без него snmpwalk покажет дерево, но не градусы.
snmpwalk -v2c -c public 10.0.0.10 1.3.6.1.4.1.674.10892.5.4.700.20
Число 674 это Dell, 232 HP. У каждого вендора свой корень OID. Ищи таблицу температур в MIB-файле руководства.
Telegraf с плагином ipmi_sensor читает ipmitool и сразу отдаёт в Prometheus-формате. Хорош, если ты уже гоняешь Telegraf для сети, дисков или логов. Минус: часть нестандартных датчиков он не видит.
Netdata ставится одной командой и рисует графики сразу. Для домашнего сервера или небольшого хостинга хватает с головой. Для парка из 50 машин упираешься в централизованные алерты, и проще вернуться к Prometheus. Тут каждый выбирает по масштабу.
Профилактика: чтобы тепловые инциденты не повторялись
Разовые действия ничего не решают. Через полгода ты забудешь, где что настроено, обновишь ядро, а датчики молча перестанут отдавать данные. Ниже то, что держит систему живой без ручного вмешательства.
Мониторинг самой системы мониторинга
Самый забываемый пункт. Ты мониторишь серверы, но не следишь, работает ли сам сборщик. Алерт обязательно нужен на факт отсутствия свежих метрик. Если экспортёр упал, ты узнаешь об этом от пользователей, а не от системы.
В Alertmanager правило absent() смотрит, приходят ли данные последние 5 минут:
groups:
- name: exporter_health
  rules:
  - alert: NodeExporterDown
    expr: absent(up{job="node"} == 1)
    for: 5m
    labels:
      severity: critical
    annotations:
      summary: "node_exporter не отдает метрики"
Такой же алерт ставь на up{job="ipmi"}. Если экспортёр IPMI не отвечает, ты не увидишь температуру вообще, и это хуже, чем один перегрев.
Резервное копирование конфигураций
Что бэкапить: конфиги prometheus.yml, правила алертов, dashboards Grafana, скрипты textfile-коллекторов, настроенные пороги IPMI. Логи и метрики бэкапить не нужно, они восстановимы.
Как часто: при каждом изменении плюс раз в сутки по крону. Храни в git-репозитории на отдельном хосте, не на самом мониторинге. Если сервер мониторинга умрёт, конфиг в его локальной папке тебе не поможет.
tar czf /backup/monitoring-$(date +%F).tar.gz \
  /etc/prometheus \
  /etc/alertmanager \
  /var/lib/grafana/dashboards \
  /usr/local/bin/textfile_collector.sh
scp /backup/monitoring-*.tar.gz backup@10.0.0.5:/srv/monitoring/
Как восстановить: разворачиваешь чистый Prometheus или Grafana, распаковываешь архив в те же пути, перезапускаешь сервисы. Проверь, что путь в --collector.textfile.directory совпадает с тем, что был до падения.
Автозапуск и порядок старта
Каждый компонент должен подниматься сам после ребута. В systemd это enabled, но с оговоркой: textfile-скрипт должен отработать до первого скрейпа Prometheus, иначе получишь дырку в метриках.
# /etc/systemd/system/thermal-textfile.service
[Unit]
Description=Generate thermal textfile metrics
Before=node_exporter.service

[Service]
Type=oneshot
ExecStart=/usr/local/bin/textfile_collector.sh
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target
systemctl daemon-reload
systemctl enable --now thermal-textfile.service
systemctl enable node_exporter prometheus
Проверь порядок командой systemctl list-dependencies node_exporter. Скрипт должен стоять выше экспортёра в дереве зависимостей.
Безопасность BMC и IPMI
IPMI не шифрует трафик и в старых версиях хранит пароли обратимо. BMC это отдельный компьютер на материнке с полным доступом к железу. Слушать его в интернет нельзя ни при каких условиях.
Что сделать:
- BMC только в management VLAN, наружу не публикуй
- Ограничь доступ через firewall по IP мониторинга и админских машин
- Смени пароль по умолчанию: root/calvin у Supermicro знают все
- Отключи неиспользуемые интерфейсы: соль, KVM, виртуальные носители
- Обнови прошивку BMC, там регулярно закрывают RCE
ipmitool user list 1
ipmitool user set password 2 'СложныйПароль'
ipmitool channel setaccess 1 2 callin=off ipmi=on link=on privilege=4
Для доступа по SSH к хостам мониторинга: только ключи, отключи password login, поставь fail2ban. Стандартный харденинг, но на мониторинговом сервере он критичен, потому что там лежат учётки ко всему парку.
Безопасное обновление и откат
Перед обновлением node_exporter или ядра проверь три вещи: сохранился ли modprobe.conf для ipmi, хватает ли прав на чтение /dev/ipmi0, и работает ли textfile-скрипт вручную.
Обновляй поэтапно, сначала на одном сервере:
apt update
apt --only-upgrade install prometheus-node-exporter
systemctl status prometheus-node-exporter
sensors
ipmitool sensor list | head
Если после апгрейда метрики пропали, откат через apt install конкретной версии из архива или через снапшот VM. Ломки при откате самого экспортёра почти не бывает, данные о температуре остаются в IPMI и SMART.
Частые вопросы
Почему мониторинг температуры сервера не работает после настройки?
Три причины в порядке частоты. Первая: модуль ipmi_si не загрузился, и /dev/ipmi0 отсутствует. Вторая: node_exporter не включил hwmon-коллектор или не указал путь к textfile. Третья: правила алертов ссылаются на метки chip и sensor, которых нет в текущих метриках. Проверь по очереди ls /dev/ipmi0, curl localhost:9100/metrics | grep temp и содержимое правил.
Как проверить, что оповещение о перегреве действительно сработает?
Не верь теории, урони порог временно. Через ipmitool sensor thresh поставь Upper Critical на 5 градусов ниже текущей температуры, подожди минуту и убедись, что алерт пришёл в почту или мессенджер. Затем верни порог обратно. То же самое с текстовым коллектором: подмени скрипт так, чтобы он писал значение выше критического.
Что делать, если ipmitool sensor не показывает датчики?
Начни с lsmod | grep ipmi. Если модули не загружены, грузи их вручную и смотри dmesg. Если Unable to find any System Interface, пробуй разные значения type и ports в modprobe. На некоторых материнках работает только type=kcs ports=0xca2, на других 0xca8. И убедись, что ты запускаешь команду от root, обычному пользователю /dev/ipmi0 недоступен.
Чем IPMI лучше Redfish и наоборот?
IPMI работает почти везде, включая старые серверы, не требует HTTPS и парсится простыми скриптами. Redfish современнее, отдаёт JSON, поддерживает аутентификацию нормально и не имеет проблем с модулями ядра. Выбирай IPMI для однородного старого парка, Redfish для новых серверов и когда важно обойти ограничения BMC по протоколам. Если есть и то и другое, Redfish стабильнее на длинной дистанции.
Почему температура ядра в lm-sensors ниже реальной?
Датчик coretemp показывает температуру в точке на кристалле, удалённой от горячего блока, и имеет смещение. Реальные значения выше на 5-15 градусов. Для точности смотри TjMax и вычисляй запас по формуле TjMax - temp. При запасе меньше 20 градусов пора чистить систему охлаждения. Для критичных нагрузок температура VRM и дисков важнее ядерной.
Можно ли обойтись без Prometheus и Grafana?
Да, если серверов мало. Хватит самодельного скрипта, который раз в минуту читает датчики и отправляет уведомление в Telegram при превышении порога. Для одного-двух хостов этого достаточно, для парка нет: нужна история, сравнение и централизованные алерты. Порог сложности обычно наступает на третьем-четвёртом сервере, когда скрипты начинают дублировать друг друга.
Что теперь работает
У тебя есть три источника температуры: IPMI через ipmitool, lm-sensors через hwmon и SMART по дискам. Все они сходятся в один Prometheus, а оттуда в Grafana и Alertmanager. Пороги выставлены руками там, где вендор их не поставил, и проверены искусственным снижением. Оповещение приходит не тогда, когда сервер уже ребутится, а когда до порога ещё есть запас и время на реакцию.
Чего стоит ожидать дальше. Через полгода обновится ядро, и sensors-detect придётся прогнать заново. Раз в квартал проверяй, что текстовый коллектор пишет свежие метрики и не копит ошибки в journalctl. Изредка заглядывай в IPMI SEL: если там начали появляться thermal-записи, значит датчик работает, но железо уже упирается в стену и пора менять термопасту или чистить радиаторы.

Author: Пудж Лютый
Оставайтесь на связи
Рецепты от IT-боли. Без воды, без рекламы, без маркетинговой шелухи.
Подписаться на IT-Аптеку →


Застрял на шаге с textfile-коллектором: скрипт руками работает, метрики в .prom пишутся, а в Prometheus их нет и в Grafana пусто. Как вообще node_exporter находит этот каталог, если я его нигде не указывал: он читает путь из дефолта или надо явно передавать параметр в юните systemd? И как понять, подхватились ли файлы, если target up, а метрик с датчиками нет?
Каталог коллектору надо явно прописать флагом —collector.textfile.directory=/var/lib/node_exporter/textfile в юните node_exporter, без него он смотрит в пустой дефолт и молча возвращает ноль строк. Проверь фактический запуск: systemctl cat node_exporter и ps aux | grep node_exporter, в аргументах должен быть виден путь. Дальше два типовых камня. Формат имени файла строго *.prom, иначе файл игнорируется. Права: процесс ходит под пользователем node_exporter, каталог должен быть ему читаем (chown node_exporter:node_exporter, режим 755), иначе файл есть, а метрик нет. Ещё момент: коллектор не перечитывает каталог мгновенно, обновление приходит при следующем scrape, плюс mtime файла должен меняться, иначе экспортёр решает, что данные старые. Проверка без Prometheus: curl -s localhost:9100/metrics | grep server_temperature. Если тут пусто, проблема в экспортёре или пути. Если строки есть, а в Prometheus нет, смотри target на странице /targets и ошибки парсинга в /graph, кривой HELP или TYPE валит весь файл целиком. Для отладки запусти node_exporter руками с нужным флагом и textfile в лог, увидишь строку уровня debug о количестве прочитанных файлов.
Застрял на шаге с текстовым коллектором: не понимаю, куда именно node_exporter должен смотреть. Я положил .prom файл в /var/lib/node_exporter/textfile, а в метриках пусто. Это как оставить записку в почтовом ящике, а сосед ждёт её в дверях. Как проверить, что мой каталог реально подключён и почему тогда пусто?
Проверь флаг запуска node_exporter. Текстовый коллектор включается опцией —collector.textfile.directory=/var/lib/node_exporter/textfile. Без неё процесс просто не знает про этот каталог, поэтому метрики не появляются.
Сделай так: systemctl cat node_exporter и посмотри строку ExecStart. Если флага нет, добавь его через override: systemctl edit node_exporter, в секцию Service впиши ExecStart= с полным путём до бинарника и флагом, затем daemon-reload и restart. Проверка быстрая: curl -s localhost:9100/metrics | grep server_temperature. Если строки есть, всё подхватилось.
Ещё два нюанса. Файл в textfile должен иметь расширение .prom, иначе игнорируется. И права: node_exporter часто работает под пользователем node_exporter, а каталог создаётся root. Дай владельца chown node_exporter:node_exporter /var/lib/node_exporter/textfile, иначе процесс не прочитает содержимое.
Старые файлы коллектор не удаляет сам. Если скрипт падает, в метриках останется последнее значение. Добавь в скрипт запись во временный файл и mv поверх готового, чтобы не было半 прочитанных данных.