

- Прогони тот же коммит три раза подряд и сравни результат. Разные результаты на одном коде означают flaky-тест, а не баг в приложении.
- Зафиксируй часовой пояс и версии зависимостей:
TZ=UTCи lock-файл убирают половину ложных падений. - Убери из модульных тестов сеть, диск и базу данных. Так результат воспроизводимый.
- Замени
sleepна ожидание условия с таймаутом. - Проверь, что в тестах вообще есть assert. Сто процентов покрытия достигаются тестами без единой проверки.
Диагноз: зелёный тест, который сам решает, когда быть красным
Каждый второй продовый дежурный знает эту картину: локально тест не проходит идеально, а в CI тот же коммит краснеет через раз. Перезапустил пайплайн, стало зелёным. Перезапустил ещё раз, снова красным. Тест не проходит стабильно, и дело тут в среде, в которой запускается сам тест, а не в коде приложения.
Я это проходил на проекте, где 14 000 тестов прогонялись 40 минут и примерно 30 из них падали каждый третий раз. Команда месяцами жала re-run, а баг искала в приложении. Проблема была в двух тестах, которые писали в один и тот же временный файл. Два дня работы, 40 минут экономии на каждом пуше.
Дальше разберём, как отличить настоящий баг от нестабильного теста, какие причины дают ложные падения и как привести это в порядок. Нужно: доступ к пайплайну CI, локально установленный тест-раннер и полчаса на первый проход. Всё, что нужно менять: один или два конфига и сами тесты.
Причины: отчего тест не проходит и откуда берётся нестабильность
Причина 1. Тест зависит от времени и часового пояса
Тест сравнивает результат функции с текущей датой или использует datetime.now() напрямую. На CI-раннере стоит UTC, у тебя локально плюс три, ночью тест уезжает за сутки на переходе даты. Проблема вылезает ровно тогда, когда её никто не ждёт: 31 декабря, при переходе на летнее время, на раннере в другой зоне. Правильное лечение: инжектировать «текущее время» как параметр или подменять системные часы фикстурой.
Причина 2. Зависимость от порядка запуска
Тест A считает, что B уже отработал и создал нужный ряд в таблице. Локально раннер гоняет их по алфавиту и всё сходится. При параллельном выполнении в pytest-xdist или JUnit parallel порядок становится неопределённым, и половина падений появится ровно на этом. Тест обязан быть независим от порядка: свой setup, свой teardown.
Причина 3. Общее изменяемое состояние между тестами
Статическая переменная, singleton-кэш, общий временный файл, один и тот же ряд в тестовой базе. Один тест меняет, второй читает, третий падает. В изоляции каждый из них зелёный. Каскадные падения почти всегда отсюда: посмотри, не пишут ли тесты в общий ресурс без уникального префикса.
Причина 4. Зависимость от внешних сервисов и сети
Модульный тест ходит в настоящий API платёжного шлюза, в staging-БД, на CDN картинок. Пока сервис отвечает быстро, тест «проходит». Сервис на 200 миллисекунд задерживается, тест падает по таймауту. Это интеграционный тест, одетый не по чину. Уточнение: модульные тесты изолированы от сети, диска и базы. Интеграционные ходят наружу, но их запускают отдельно и с явным тегом.
Причина 5. Смешение типов тестов в одном прогоне
Юнит, интеграционные и нагрузочные тесты запускаются одной командой, на одном раннере, в одном пуле. Метрики искажены: непонятно, что именно сломалось и сколько времени занимает каждая категория. А ещё часть из них быстро покрывает зависимости, а часть медленно, и общий таймаут режет хвост.
Причина 6. Плавающие версии зависимостей
В манифесте написано requests>=2.20, без lock-файла. У тебя локально кэш тянет 2.28, на CI свежий раннер тянет 2.31. Один из них ведёт себя иначе, тест падает не у всех. Воспроизводится ровно на части окружений, что бесит больше всего. Лечение: lock-файл и одинаковый образ раннера.
Причина 7. Тест был, а assert в нём не было
Классика: тест вызывает функцию, не падает и считается пройденным. Функция вернула None вместо ожидаемого объекта, а тест даже не глянул. Покрытие растёт, доверие падает. Ловится мутационным тестированием: если мутация не убивает тест, значит проверка слабая.
Причина 8. Sleep вместо ожидания события
Асинхронный воркер запущен, тест спит три секунды и проверяет результат. На быстром раннере стабильно зелено, на загруженном CI три секунды превращаются в пять, тест краснеет. Лечение: ждать конкретное условие с таймаутом, а не фиксированное время.
Рецепт: как за один проход отсеять настоящие падения от ложных
Подготовка: что должно быть под рукой
Ничего экзотического не нужно. Проверь, что есть доступ к логам пайплайна, локальный запуск тестов работает и не падает сам по себе, а версия раннера на раннере совпадает с локальной. Первый шаг рецепта это воспроизведение падения три раза подряд на одном коммите, правка тестов будет позже.
| Компонент | Версия | Комментарий |
|---|---|---|
| Ubuntu | 22.04 LTS или 24.04 LTS | На CI можно тот же образ |
| Python | 3.11 или 3.12 | 3.13 тоже работает, но живой опыт меньше |
| pytest | актуальная на момент написания, проверь релизы | pytest-xdist нужен для параллельного прогона |
| pytest-xdist | актуальная на момент написания, проверь релизы | Для выявления гонок |
| Node.js (если фронтенд-тесты) | 20 LTS или 22 LTS | Один мажор на всех, никаких «у меня 18» |
| PowerShell | 7.4+ | Если тесты на .NET, PowerShell 7 гоняется на Linux |
На момент публикации актуальны указанные версии. Перед установкой проверь свежие релизы на официальных страницах Python, pytest и Node.js.
| Порт | Протокол | Назначение | Доступен снаружи? |
|---|---|---|---|
| 5432 | TCP | PostgreSQL тестовой базы | Нет, только localhost или внутренняя сеть CI |
| 6379 | TCP | Redis для тестовых очередей | Нет, localhost |
| 8081 | TCP | Мок-сервис внешнего API | Нет, только внутри пода CI |
| 9000 | TCP | Внутренний тестовый HTTP-сервер приложения | Нет, закрыт наружу firewall |
| 22 | TCP | SSH на тестовый раннер | Только с whitelisted IP, ключи обязательны |
Схема: как тесты ходят по кругу
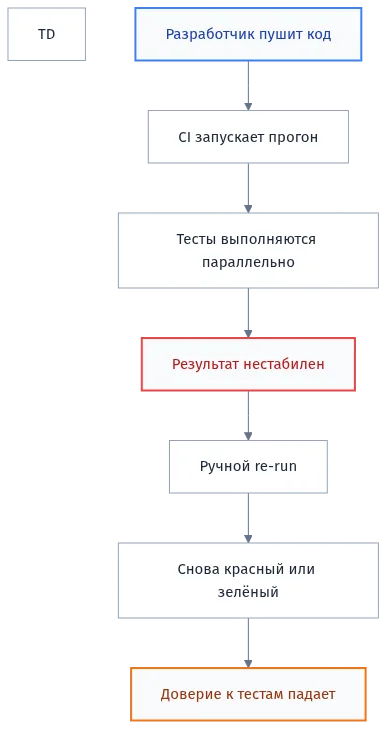
Шаг 1. Воспроизведи падение три раза подряд
Зачем: ты хочешь чётное число фактов, а не «вроде ломалось на прошлой неделе». Гоняешь один и тот же коммит, локально, три раза. Если результат разный, тест нестабильный и дальше мы лечим именно это. Если три раза одинаково красный, у тебя настоящий баг и тесты ни при чём.
git checkout 7a3f92c
for i in 1 2 3; do
  TZ=UTC pytest -q --timeout=60 2>&1 | tail -n 3
done
Ожидаемый результат: три строки с итогом. Если среди трёх прогонов есть хотя бы один с отличающимся результатом, тест нестабильный.
Шаг 2. Заставь тест показать, от чего он зависит
Зачем: pytest-плагин pytest-randomly перемешивает порядок тестов. Если после перемешивания тест падает всегда, причина в зависимостях между тестами. Если падает реже, чем раньше, значит часть нестабильности от порядка, а часть от чего-то другого.
pip install pytest-randomly pytest-repeat
TZ=UTC pytest --randomly-seed=0 -x -q
TZ=UTC pytest --count=10 -q tests/test_orders.py
Ожидаемый результат: pytest-randomly печатает использованное зерно в начале вывода. Запомни его, чтобы воспроизводить падение. —count=10 гоняет один файл десять раз подряд: если падение повторяется, оно локально воспроизводимо.
Шаг 3. Включи параллельный режим и проверь гонки
Зачем: pytest-xdist выявляет тесты, которые молча рассчитывают на последовательное выполнение. Гонка по общему ресурсу почти всегда всплывает здесь.
pip install pytest-xdist
TZ=UTC pytest -n 4 -q
TZ=UTC pytest -n 4 --dist=loadscope -q
Ожидаемый результат: часть тестов, которые в одиночку проходят, падает. Это и есть гонки. Запиши их имена, они пойдут в первую очередь на починку.
Шаг 4. Зафиксируй окружение: время, локаль, зависимости
Зачем: без фиксированного TZ и лок-файла ты лечишь симптом. Сначала фиксируешь окружение, потом уже ищешь виноватый тест. Прогон должен быть идентичен между локалью и CI.
export TZ=UTC
export LC_ALL=C.UTF-8
export LANG=C.UTF-8
pip freeze > requirements.lock
pip install -r requirements.lock
Ожидаемый результат: тесты, которые падали из-за TZ, локально зелёные и на CI тоже. Дальше поменяй TZ на Europe/Moscow и убедись, что поведение то же: если результат поехал, значит остались тесты, завязанные на локальные часы, их и ищи.
Шаг 5. Убери из модульных тестов сеть и диск
Зачем: модульный тест должен быть изолирован. Сеть, диск и база делают его медленным и нестабильным. Подменяй зависимости фикстурами и моками. Тут дело и в flaky, и в секундах: 14 000 тестов без сети прогоняются в разы быстрее, чем с ней.
# tests/conftest.py
import pytest
from unittest import mock

@pytest.fixture(autouse=True)
def _no_network(monkeypatch):
    def boom(*args, **kwargs):
        raise RuntimeError("network access in unit test")
    monkeypatch.setattr("socket.socket.connect", boom)
    yield

@pytest.fixture
def fixed_time():
    with mock.patch("app.orders.utcnow") as m:
        m.return_value = __import__("datetime").datetime(2025, 1, 1, 12, 0, 0)
        yield m
Ожидаемый результат: если какой-то модульный тест всё ещё ходит в сеть, он упадёт с понятным сообщением. Это и есть цель: падать явно, а не мигающе.
Шаг 6. Замени sleep на ожидание условия
Зачем: time.sleep(3) это ставка на то, что CI успеет. На загруженном раннере этот момент придёт позже, и тест расскажет тебе об этом красным. Правильная схема: ждать конкретное состояние с таймаутом и опросом.
import time

def wait_for(predicate, timeout=10.0, interval=0.05):
    deadline = time.monotonic() + timeout
    while time.monotonic() < deadline:
        if predicate():
            return True
        time.sleep(interval)
    raise AssertionError("condition not met within timeout")

# в тесте
assert wait_for(lambda: job.status == "done")
Ожидаемый результат: тест ждёт столько, сколько нужно, но не больше таймаута. Стабильность растёт, общее время прогона не раздувается.
Шаг 7. Проверь, что assert не мимо
Зачем: тест может быть зелёным, но ничего не проверять. Мутационное тестирование даёт прямой ответ. Если мутация выживает, значит тест хлипкий. Если мутаций много и непонятно с чего начать, начни с ключевых модулей: авторизация, биллинг, оформление заказа.
pip install mutmut
mutmut run --paths-to-mutate app/orders/ --tests-dir tests/
mutmut results
mutmut show
Ожидаемый результат: список выживших мутаций по каждому модулю. Не гонись за нулём, цель в том, чтобы выживших не было в критичных сценариях.
Шаг 8. Проверь сравнение строк в PowerShell-тестах
Зачем: в PowerShell 7+ сравнение строк регистронезависимо по умолчанию. Тест if ($result -eq "Ok") пройдёт и при "OK", и при "ok", а приложение при этом ждёт строго "Ok". Ложно проходящая проверка хуже падающей, потому что она молчит.
# Не так: регистронезависимо, ложно зелено
if ($result -eq "Ok") { }

# Так: регистрозависимо, отражает реальное поведение
if ($result -ceq "Ok") { }
if ($result -cne "Ok") { throw "unexpected payload casing" }
Ожидаемый результат: тесты, которые раньше проходили на неверном регистре, теперь падают. Это хорошо: они ловили ветку, которую продовый код не выдержит.
Безопасность на этапе настройки тестовой среды
Тестовое окружение это не «песочница без последствий». Часто в тестах лежат реальные ключи, тестовые пользователи с правами, доступ к внутренним сервисам. Минимум, который стоит сделать сразу:
- Отдельный пользователь БД для тестов, без прав SUPERUSER, с ограничением на конкретную тестовую схему. Никаких прав на прод-схему через тот же DSN.
- Тестовая база и Redis слушают только 127.0.0.1, а не 0.0.0.0. Firewall закрывает их наружу по умолчанию.
- SSH на раннер: вход только по ключу, отключён пароль, отключён root. Если раннер смотрит наружу, ставь fail2ban.
- Секреты тестов передавай переменными окружения из CI-vault, а не через .env в репозитории. Публикация ключа в истории git дороже, чем время на настройку vault.
- После прогона чисти тестовые данные. Не оставляй таблицы с реальными ПДн в тестовой базе.
Проверка: как убедиться, что тесты стали стабильными
Прошёл рецепт, теперь подтверди результат фактами. Без этого шага ты не знаешь, поймал ли ты проблему или отложил её на следующую неделю.
Проверка 1. Многократный прогон на одном коммите
Гоняй тот же коммит десять раз. Раньше краснело один раз из трёх, теперь должно быть ноль из десяти. Если хоть раз красный, возвращайся к шагам 5 и 6.
for i in $(seq 1 10); do
  TZ=UTC pytest -q --timeout=60 2>&1 | tail -n 1
done
Ожидаемый результат: десять одинаковых строк с итогом. Один и тот же коммит, одна и та же картина.
Проверка 2. Параллельный прогон
Поднимай параллельность до уровня CI. Если локально 8 воркеров дают другой результат, чем 4, ты ещё не закончил.
TZ=UTC pytest -n 8 -q --timeout=60
TZ=UTC pytest -n 8 --dist=loadscope -q --timeout=60
Ожидаемый результат: итог совпадает между двумя запусками. Расхождение означает, что осталась зависимость от порядка в пределах одного скоупа.
Проверка 3. Смена TZ и локали
Один и тот же коммит под тремя разными TZ. Тесты, которые не завязаны на время, будут зелёными везде. Тесты, которые ещё завязаны, себя выдадут.
for tz in UTC Europe/Moscow America/New_York; do
  echo "TZ=$tz"
  TZ=$tz LC_ALL=C.UTF-8 pytest -q --timeout=60 2>&1 | tail -n 1
done
Ожидаемый результат: три одинаковые строки. Если под America/New_York другая, ищи в тестах обращения к локальным датам и часовым поясам.
Проверка 4. Ручной запуск на чистом окружении
Ставь зависимости из лок-файла в свежий venv. Тут вылезают тесты, которые работали только потому, что у тебя в системе был ещё один пакет. Это самая частая причина «локально зелено, на CI красно».
python3.12 -m venv .venv-clean
. .venv-clean/bin/activate
pip install -r requirements.lock
TZ=UTC pytest -q --timeout=60
Ожидаемый результат: прогон завершается тем же итогом, что и в CI. Если отличается, lock-файл не полный или в раннере другой набор системных пакетов.
Проверка 5. Просмотр истории в CI
Прогони пайплайн десять раз подряд на одном коммите. Раньше каждый третий был красный, теперь должен быть ноль. Если CI умеет пометить коммит тегом, чтобы вернуться к нему через день, сделай это, потому что нестабильность иногда с задержкой.
git log --oneline -1
git tag flaky-check-$(date +%Y%m%d)
git push origin flaky-check-$(date +%Y%m%d)
Ожидаемый результат: тег на коммите, к которому можно вернуться. Через сутки прогони этот тег руками и сравни с первой десяткой. Если всё ещё ноль красных, ты закрыл вопрос, а не замазал лог.
Осложнения: таймзоны, гонки и всё, что ломает тест не у тебя
Ты нашёл нестабильный тест, изолировал его, он зелёный. Запускаешь весь набор, снова красный. Значит, проблема в окружении, где он живёт. Ниже семь сценариев, которые я вытаскивал из продакшна чаще всего. Формат один: ошибка, причина, решение, команда.
Тест падает ночью и проходит днём
В CI ночной прогон красный, утренний зелёный. Разница ровно в несколько часов. Причина в зависимостях от текущего времени: datetime.now(), time.time(), сравнение с полуночью, логика «если сейчас выходной». Ночью попадаешь на границу суток, код уходит в ветку, которую ты не тестировал.
Решение: inject время. Тест получает текущую дату как параметр и передаёт фиксированную точку. Никаких freezegun через monkeypatch, если можно передать аргумент.
# было: функция сама зовёт datetime.now()
def is_expired(token):
    return token.expires_at < datetime.now()

# стало: время приходит извне
def is_expired(token, now=None):
    now = now or datetime.now(timezone.utc)
    return token.expires_at < now

# тест
def test_token_expired():
    token = Token(expires_at=datetime(2026, 1, 1, tzinfo=timezone.utc))
    assert is_expired(token, now=datetime(2026, 1, 2, tzinfo=timezone.utc))
Проверить, что нигде не осталось скрытого datetime.now() без аргумента:
grep -rn "datetime\.now()" src/ | grep -v "timezone.utc"
grep -rn "time\.time()" src/
grep -rn "date\.today()" src/
Каждая строка из вывода это потенциальный flaky тест. Особенно если в файле уже есть тест на этот код.
Локально TZ=Europe/Moscow, в CI TZ=UTC
Ты видишь падение с ошибкой вида AssertionError: '01.01.2026' != '31.12.2025'. Смотришь на дату, вроде совпадает, а смещение уже на сутки. Причина: где-то в коде date.today() или datetime.now() без часового пояса, а окружение CI живёт в UTC.
TZ в конфиге CI как единственное решение прячет баг. Правильный путь: работать только с aware-датами.
from datetime import datetime, timezone

# плохо
now = datetime.now()

# хорошо
now = datetime.now(timezone.utc)
Проверка, что в проекте нет naive-дат:
grep -rn "datetime\.utcnow()" src/
utcnow() возвращает naive-дату и уже помечен deprecated в Python 3.12+. Меняй на datetime.now(timezone.utc).
Тест падает только в параллельном запуске
pytest-xdist с ключом -n auto, набор красный. Без -n всё зелёное. Причина: два воркера пишут в один и тот же файл, используют одну и ту же таблицу в SQLite или делят глобальный счётчик. Классика: фикстура уровня session создаёт временный каталог с фиксированным именем.
Решение: каждому воркеру отдельный namespace. pytest-xdist даёт worker_id из config.
import pytest

@pytest.fixture(scope="session")
def temp_workspace(tmp_path_factory, worker_id):
    if worker_id == "master":
        return tmp_path_factory.mktemp("work")
    root = tmp_path_factory.getbasetemp().parent
    return root / f"work_{worker_id}"

@pytest.fixture(scope="session")
def db_url(temp_workspace):
    return f"sqlite:///{temp_workspace}/test.db"
Проверь, что тест действительно изолирован:
pytest -p no:randomly -n 4 --tb=short tests/
pytest -p no:randomly --tb=short tests/
Если первая команда красная, а вторая зелёная, дело в общем состоянии. Ищи глобальные переменные модуля, singleton-кэши, файлы в /tmp с фиксированным именем.
Тест падает только при случайном порядке
Стоит pytest-randomly или --random-order, набор красный. Без них зелёный. Причина: тест не убирает за собой, а следующий тест ожидает чистого состояния. Один тест оставил строку в базе, другой её находит и падает на количестве.
Решение: фикстуры с правильным scope, каждый тест с чистой базой. Транзакция, rollback, чистый state.
@pytest.fixture
def db(session_factory):
    session = session_factory()
    yield session
    session.rollback()
    session.close()
Ловить виновника удобнее через pytest --random-order-seed=1. Каждый seed даёт стабильный порядок. Запускаешь по кругу, находишь минимальный набор тестов, который воспроизводит падение.
for seed in $(seq 1 50); do
  pytest --random-order-seed=$seed -q tests/ 2>&1 | grep -E "FAILED|failed" && echo "seed=$seed"
done
Пара десятков итераций обычно вылавливает пару проблемных тестов.
Тест с sleep падает на медленном CI
Ты видишь requests.exceptions.Timeout или пустой результат после time.sleep(1). Локально сервис отвечал за 0.8 секунды, в CI с двумя ядрами не успевает. Причина: фиксированный sleep это гадание.
Решение: ждать условие с таймаутом, а не фиксированное время.
import time

def wait_for(predicate, timeout=5.0, interval=0.05):
    deadline = time.monotonic() + timeout
    while time.monotonic() < deadline:
        if predicate():
            return True
        time.sleep(interval)
    return False

def test_task_done(client, task_id):
    client.post(f"/tasks/{task_id}/run")
    assert wait_for(lambda: client.get(f"/tasks/{task_id}").json()["status"] == "done")
Такой тест на быстром окружении отработает за 50 мс, на медленном за секунду. Без падений. Ищи все sleep в тестах:
grep -rn "time\.sleep" tests/
grep -rn "Task\.Delay\|await asyncio\.sleep" tests/
Тест проходит локально, падает в CI из-за зависимостей
pip ставит requests==2.31.0 локально, в CI приходит 2.32.0 и ломает поведение try/except. Причина: не зафиксированы зависимости. requirements.txt без версий это лотерея, которая выиграла у тебя и проиграла на runner.
Решение: lock-файл. pip freeze в requirements.lock, или переход на poetry / uv / pdm.
# pip-tools
pip install pip-tools
pip-compile --generate-hashes requirements.in -o requirements.txt
pip-sync requirements.txt
Хеши --generate-hashes закрывают и подмену пакета, что важно не только для тестов.
Assertion не ловит баг, тест зелёный, баг в проде
Ты уверен, что тест покрывает случай, а баг всё равно ушёл. Открываешь тест и видишь assert response.status_code is not None. Или assert result, где result это пустой список. Причина: слабый assert.
Решение: проверяй конкретное значение. Не assert result, а assert result == [{"id": 1, "status": "ok"}].
# мутации находят слабые тесты
pip install mutmut
mutmut run --paths-to-mutate=src/ --tests-dir=tests/
mutmut results
Выжившая мутация означает, что тест не различает поведение. Каждую выжившую смотри руками: либо тест слабый, либо код можно упростить. Про PowerShell отдельно: в PS 7+ сравнение строк по умолчанию регистронезависимо, "ABC" -eq "abc" даёт True. Если твой код должен различать регистр, тест с -eq пропустит баг.
"ABC" -eq "abc"        # True в PS 7+
"ABC" -ceq "abc"       # False, регистрозависимое сравнение
Альтернативы: чем ещё лечить нестабильные тесты
Изоляция через фикстуры и замена времени на inject это базовый путь. Но есть ещё четыре подхода, которые в отдельных ситуациях работают лучше.
| Подход | Плюсы | Минусы | Когда брать |
|---|---|---|---|
| Testcontainers | Настоящая база в докере, полное соответствие прод | Медленный старт, тянет Docker в CI | Интеграционные тесты против реального PostgreSQL |
| Mock на границе модуля | Быстро, без сети | Тест проверяет мок, а не код | Модульные тесты бизнес-логики |
| Contract testing (Pact) | Ловит несовместимость API до деплоя | Требует реестра контрактов | Микросервисы с независимыми командами |
| Property-based (Hypothesis) | Находит edge case, который руками не придёт в голову | Дольше, нужен опыт | Функции с числами, парсерами, граничными условиями |
Почему я выбираю фикстуры и inject времени как основной рецепт: они не требуют новой инфраструктуры. Testcontainers полезны, но добавляют Docker в CI и +2-5 минут на прогон. Если у тебя 3000 тестов и 10 минут пайплайн, каждый Docker контейнер это ещё 30 секунд. По факту окупается, когда ты тестируешь SQL-специфику, которой нет в SQLite.
Hypothesis стоит взять точечно. Пример: у тебя функция нормализации телефона, которая падает на невидимых юникод-символах. Руками такой тест пишешь неделю.
from hypothesis import given, strategies as st

@given(st.text(min_size=1, max_size=20))
def test_normalize_phone_never_crashes(raw):
    result = normalize_phone(raw)
    assert isinstance(result, str)
Если тест находит падение, Hypothesis выдаёт минимальный воспроизводящий пример. Обычно это один символ, который ты бы никогда не догадался подставить.
Профилактика: чтобы не ловить flaky руками
Мониторинг результатов прогонов
Один прогон не показывает flaky. Показывает статистика. Если у тебя 100 тестов и 20 прогонов в день, за неделю набирается 14000 запусков. Тест, который падает 1 раз из 1000, за эту неделю покажет себя 14 раз. Это уже видно.
Что мониторить: успешность каждого теста по имени, отдельно от общего статуса пайплайна. JUnit XML это входной формат почти для всего.
pytest --junitxml=report.xml tests/
Дальше report.xml уходит в систему, которая умеет считать частоту: Grafana + SQLite, Allure TestOps, встроенные дашборды GitLab.
Если разворачивать нечего, работает минимальный скрипт на cron:
import xml.etree.ElementTree as ET
import sqlite3, sys, datetime

db = sqlite3.connect("/var/lib/teststats/stats.db")
db.execute("""CREATE TABLE IF NOT EXISTS runs (
  ts TEXT, suite TEXT, test TEXT, status TEXT, duration REAL
)""")

tree = ET.parse(sys.argv[1])
for case in tree.iter("testcase"):
    status = "pass"
    for child in case:
        if child.tag in ("failure", "error"):
            status = "fail"
    db.execute("INSERT INTO runs VALUES (?,?,?,?,?)", (
        datetime.datetime.utcnow().isoformat(),
        sys.argv[2], case.get("classname") + "." + case.get("name"),
        status, float(case.get("time", 0))
    ))
db.commit()
Запрос для поиска нестабильных:
SELECT test,
       COUNT(*) AS total,
       SUM(CASE WHEN status='fail' THEN 1 ELSE 0 END) AS fails,
       ROUND(100.0 * SUM(CASE WHEN status='fail' THEN 1 ELSE 0 END) / COUNT(*), 2) AS fail_rate
FROM runs
WHERE ts > datetime('now', '-14 days')
GROUP BY test
HAVING fails > 0 AND fails < total
ORDER BY fail_rate DESC
LIMIT 50;
Тест, который падает всегда, ты знаешь и так. Интересно то, что в выдаче посередине: 2-10 процентов падений. Это и есть flaky.
Автозапуск прогонов
Ловить нестабильные тесты на реальных коммитах это половина дела. Вторая половина: гонять ночной прогон с другими параметрами. Другой TZ, другой seed, параллельность.
# crontab -e
0 3 * * * TZ=Pacific/Auckland /usr/bin/pytest /srv/app/tests/ \
  --random-order-seed=$$(date +\%s) --junitxml=/var/log/tests/night.xml \
  --tb=short >> /var/log/tests/night.log 2>&1
30 3 * * * python /opt/teststats/parse.py /var/log/tests/night.xml night
Смена TZ ночью найдёт все места, где код неявно рассчитывает на твоё время. Если за месяц ночных прогонов не было падений на TZ, а потом ты меняешь хостинг на другой регион, ты уже знаешь, что смотреть.
Бэкап: что, как часто, где хранить, как восстановить
| Что | Как часто | Где | Восстановление |
|---|---|---|---|
| Lock-файл зависимостей | При каждом изменении | Git, вместе с кодом | git checkout известного коммита, pip-sync |
| База статистики прогонов | Ежедневно | Отдельный сервер или S3-совместимое хранилище | sqlite3 stats.db ".restore backup.db" |
| Конфиги CI и фикстуры | При каждом коммите | Git | git revert коммита, который всё сломал |
| Образы тестовых окружений | При релизе | Registry с tag по версии | docker pull image:sha |
| Golden-снапшоты (если есть) | При изменении формата | Git, в отдельной папке | git log по папке, вернуть файл |
База статистики не критичная, но терять её жалко: полгода данных это понимание, какие тесты у тебя в зоне риска. Бэкап SQLite:
sqlite3 /var/lib/teststats/stats.db ".backup /backup/stats-$(date +%F).db"
find /backup -name "stats-*.db" -mtime +30 -delete
Первая команда делает консистентный бэкап без остановки писателя. Вторая чистит старое. Не копируй файл через cp пока есть активные записи, можно поймать момент коммита и получить битую копию.
Безопасность тестового окружения
Тестовое окружение часто расслабленное, и туда лезут вещи, которых не должно быть в проде. Что проверить:
- Тестовые секреты не совпадают с продакшн. Если тестовый токен доступа к платежам это тот же, что в проде, у тебя двойная дыра.
- БД тестов не доступна снаружи. В 99% случаев она должна быть на localhost или внутри docker-сети.
- CI-runner не хранит артефакты с секретами. Логи падений иногда содержат окружение целиком.
- fail2ban на тестовом хосте, если он доступен через SSH. Правило стандартное, 3 попытки пароля за 10 минут и бан.
# БД только на localhost
sudo ss -tlnp | grep 5432
# должно быть: LISTEN 127.0.0.1:5432
# если видишь 0.0.0.0:5432, срочно правь postgresql.conf

sudo -u postgres psql -c "ALTER SYSTEM SET listen_addresses = 'localhost';"
sudo systemctl reload postgresql
Тестовые токены храни в переменных CI с флагом masked. Не в коде, не в фикстурах, не в комментариях «это только для тестов».
Обновление и откат
Обновление pytest и плагинов безопаснее делать в отдельной ветке. За две недели до реального обновления запусти её на ночном расписании, посмотри, что падает. Минорные версии обычно без сюрпризов, но плагины вроде pytest-asyncio любят ломать модели event loop при мажорном переходе.
# ветка для обновления
git checkout -b deps/pytest-update
pip-compile --upgrade requirements.in -o requirements.txt
git commit -am "bump pytest stack"
# через две недели ночных прогонов, если зелёно, merge
Откат: git revert коммита с обновлением, и pip-sync по предыдущему lock-файлу. Держи один предыдущий lock в отдельном файле requirements.prev.txt.
git log --oneline requirements.txt | head -5
git revert
pip-sync requirements.prev.txt
Обязательно фиксируй версии интерпретатора. .python-version для pyenv, runtime.txt для Heroku, PYTHON_VERSION в env CI. Мелочь, а ловит переход с 3.11 на 3.12, где у тебя поломался какой-нибудь плагин.
FAQ
Почему тест проходит локально, но падает в CI?
Три частые причины: другой часовой пояс, другие версии зависимостей, другое железо. Проверь TZ в CI, зафиксируй зависимости через lock-файл, посмотри на тайминги в отчёте JUnit. Если локально 0.1 секунды, а в CI 1.5, у тебя где-то sleep или timeout, который задевает границу.
Как проверить, что тесты не flaky?
Гоняй ночной прогон с рандомизацией порядка, разными TZ и параллельностью. Собирай результаты в базу и считай частоту падений по имени теста. Тест с 1% падений за 1000 запусков покажет себя. Единичный зелёный прогон не доказывает ничего, доказательство это статистика за неделю.
Что делать, если тест падает только при параллельном запуске?
Ищи общее состояние: файлы с фиксированным именем, общие таблицы БД, глобальные переменные модуля. Дай каждому воркеру отдельный namespace через worker_id в pytest-xdist. Проверь, что фикстуры не пересекаются по scope. Файлы в /tmp создавай через tmp_path, не через tempfile.mkstemp с префиксом.
Чем flaky-тест отличается от сломанного теста?
Сломанный падает всегда, flaky падает иногда. Сломанный ты видишь в CI сразу, flaky живёт месяцами: команда привыкает перезапускать пайплайн, и в момент реального бага никто не верит падению. По поведенческим факторам flaky опаснее: он размывает доверие к тестам.
Нужно ли стремиться к 100% покрытию?
Нет. 100% line coverage достижимо тестами без единого assert. Ты обойдёшь все строки, но не проверишь поведение. Полезнее покрытие по ветвям плюс мутационное тестирование на критичных модулях. Платежи, аутентификация, парсеры это те места, где каждая мутация должна быть убита. Утилиты форматирования покрывай как получится.
Тест не ходит в базу данных, но всё равно нестабилен. Как так?
Он может ходить в сеть, к файловой системе, к DNS, к системным часам. Всё, что за пределами процесса, потенциальный источник flaky. Проверь requests.get, socket.getaddrinfo, os.stat по подозрительным путям. Если модульный тест делает любой из этих вызовов, он не модульный.
Прогноз: что ты теперь умеешь
Ты умеешь найти flaky-тест по статистике, а не по интуиции. Ты знаешь, что делать с таймзонами, с параллельностью, со sleep'ами и слабыми assert'ами. У тебя есть ночной прогон с рандомизацией, база с результатами и мониторинг по частоте падений. Это ровно то, что позволяет чинить проблему до того, как она закроет релиз.
Ближайшие две недели: настрой ночной прогон, убери все datetime.now() без таймзоны, добавь мутационное тестирование на один критичный модуль. Через месяц у тебя будет список нестабильных тестов и план, что с ними делать. Если через месяц ничего не найдётся, значит, у тебя действительно чистый набор, и это уже результат.
pytest --tb=long -p no:randomly --random-order-seed=1 tests/ для проблемного набора, по нему видно больше, чем по описанию.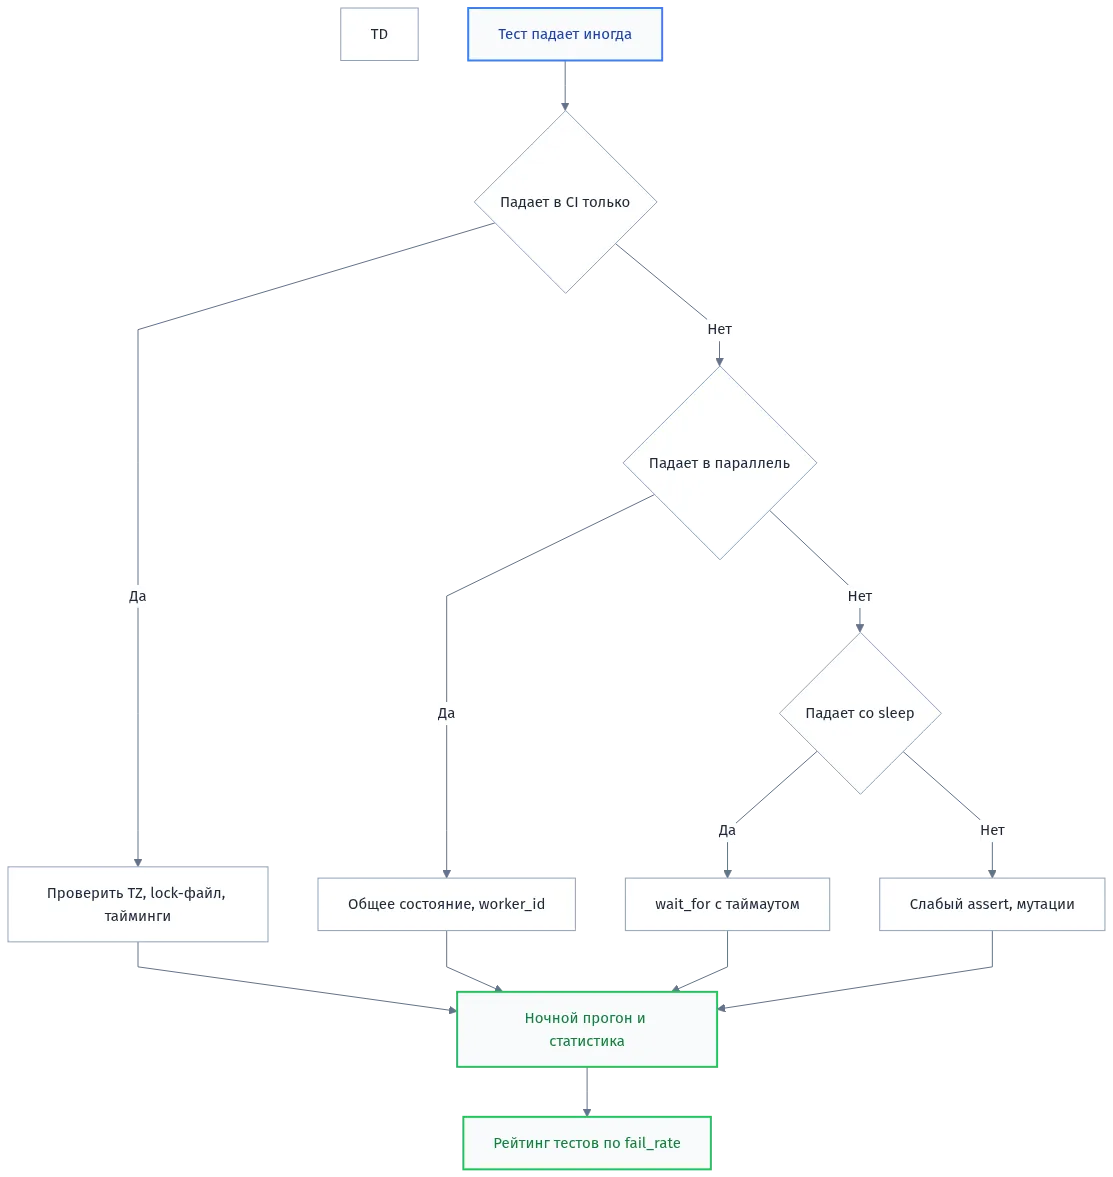

Author: Александра Сергеевна
Оставайтесь на связи
Рецепты от IT-боли. Без воды, без рекламы, без маркетинговой шелухи.
Подписаться на IT-Аптеку →


Поймал flaky в тестах на дату рождения: код делал возраст через datetime.now().date() — birth_date, а в CI ночью по UTC возраст получался на год меньше. Помогало только TZ=UTC везде, включая Docker и сам раннер. Но почему это проявляется не всегда, а только в узком окне? Заложено так, будто тест каждый раз играет в рулетку с календарём. Как правильно изолировать вычисление возраста, если дата рождения приходит из фикстуры?
Симптом классический. Внутри процесса TZ подхватывается один раз при старте, поэтому export TZ=UTC перед pytest помогает, а os.environ[‘TZ’] в середине прогона почти всегда уже нет: Си использует tzset() на старте, поэтому переопределение через monkeypatch требует вызова time.tzset(). Надёжнее вообще не трогать TZ-окружение, а инжектить время в функцию: передавай now=datetime(2024, 1, 1, tzinfo=timezone.utc). Тест на возраст не должен зависеть от системных часов. Для этого подойдёт freezegun: @freeze_time(‘2024-01-01’) фиксирует datetime.now и date.today внутри теста, не задевая конфиг раннера. Проверь границы: 28 февраля в високосный и невисокосный год, 23:59 UTC и следующий день в Europe/Moscow. Если фикстура birth_date хранит дату без tz, сравнивай date-объекты после явного приведения к UTC, иначе разница в один день будет плавающей.
Столкнулся с тем, чего в статье нет. У нас монорепа, тесты на Python и Go в одном пайплайне, и Go-тесты пишут в ту же тестовую базу, что и Python. Плюс на CI раннеры переиспользуются между джобами, локально у меня Docker с чистой базой каждый раз. Три прогона подряд дают то зелёный, то красный, причём падает всегда Go-тест, который проверяет запись в базу, хотя Python-тест в этот момент ничего туда не пишет. Локально повторить не могу, потому что база после каждого прогона сносится контейнером. Как в такой ситуации поймать, кто именно оставляет мусор в базе, если у меня нет доступа к состоянию раннера после падения?
Тут вопрос не в том, кто оставляет мусор, а в том, как зафиксировать состояние раннера между джобами. Если у тебя нет доступа к базе после падения, включи логирование в самих тестах: перед записью делай SELECT по уникальному префиксу и пиши в лог, что нашлось. Например, в Go test добавь t.Logf с результатом проверки. В Python фикстура до теста может дампить список строк с этим префиксом. Дальше прогони в CI с флагом -v и посмотри, что реально лежит в базе на момент старта Go-теста. Второй момент: переиспользуемые раннеры почти всегда означают, что Docker volume не удаляется. Проверь, не мапится ли /var/lib/postgresql между джобами. Если да, вынеси базу в отдельный сервис-контейнер с флагом tmpfs или поднимай свой инстанс на каждый джоб через docker run —rm. И третье: у Go и Python могут быть разные роли в базе, и один из них пишет в схему public, а второй в свою. Проверь search_path. Если это так, тест из Go просто видит чужие данные. Начни с t.Logf и дампа строк, это даст ответ за один прогон.